
切换深浅主题
第 9 章:向量怎样变成下一 Token 的预测概率
你后来问“这里还得有一个什么预测函数吧”,这一问不能等到讲损失时才补。我们先完整说明h怎样变成候选分数和概率,再进入训练例子。
下面用θ统称网络参数,用Fθ表示整套网络;h_i是它在第i位置的最终行向量。下标i在这一章始终表示位置。
9.1 最后位置的向量,为什么可以用于整个前缀的预测
这里必须区分两个概念:
最后一个 Token 的原始向量  和 经过多层 Transformer 计算后的最终隐藏向量
 。
它们不是同一个东西。
最开始:
这时它主要是「华法林」这个 Token 的初始表示,外加可能的位置相关信息。
经过第一层 Attention:

它开始获得前面 Token 的信息。
再经过输出投影、残差连接、前馈网络,得到第一层更新后的隐藏表示。
第二层又重新计算 Q、K、V,进一步整合信息。
反复进行  层后:
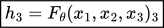
也就是说,最后得到的 已经是一个依赖整段前缀的向量表示。
但这里有一个细节:它并不需要精确地保存句子中的全部原始信息。
它只需要在训练目标下,保留和组织足够有用的信息,以便模型预测后续 Token。
例如:
患者服用华法林后出现……
最后一个位置的隐藏向量可能编码了与患者、用药及当前句子结构有关的信息,使模型能够为下一个 Token 计算概率。
9.2 先看完整的数学关系
假设输入:
患者服用华法林后出现
首先经过 Transformer:
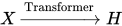
其中  是各个 Token 经过多层处理后的隐藏向量矩阵。
我们取最后一个位置的隐藏向量:

然后进行一次线性变换:
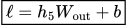
其中:
 :输出层的权重矩阵,也需要通过训练学习。
 :可选的偏置向量。
 :输出分数向量(Logits),每个候选 Token 对应一个分数。
如果模型的隐藏向量维度是 512,词表有 50,000 个 Token:

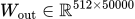
因此:

也就是模型一次性算出了 50,000 个候选 Token 的分数。
9.3 但是分数还不是概率
这就又需要我们之前学过的 Softmax。
假设词表只有三个候选 Token,输出层计算得到:
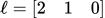
它们分别对应:
| Token | 输出分数(Logit) |
|---|---|
| 黑便 | 2 |
| 呕血 | 1 |
| 呼吸困难 | 0 |
经过 Softmax:
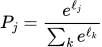
得到:
现在我们才真正得到了预测概率。
注意,这是第二次遇到 Softmax:
- Attention 的 Softmax:计算不同输入 Token 的注意力权重。
- 输出层的 Softmax:计算下一个 Token 的预测概率。
两者作用不同。
9.4 所以完整的预测函数是什么?
我们将整个 Transformer 记为一个函数:

其中  表示 Transformer 内部的所有可训练参数,包括各层的
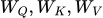 等。
取最后一个位置的向量:

那么预测函数就是:
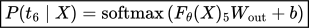
注意,这个函数的输出不是一个概率,而是整个词表上的概率分布。
我们取其中「黑便」对应的概率,再计算损失:
因此整个过程实际上是:
9.5 把预测函数中的每个符号读出来
 表示前面整套Transformer计算;θ是其中参数的统称,不是输入文本。
 表示结果矩阵的第5行,不是第五个坐标。
 是输出层可训练矩阵。有些资料记作U,意思相同;本版主线沿用原对话的Wout。b是可选偏置,ℓ是输出分数向量,不是损失L。
式子 在这里简写整个下一Token分布。要读“黑便概率”这一个数,应写成
 。竖线读作“在X已知的条件下”。
Attention的Softmax沿输入位置分比例;输出Softmax沿词表分概率。前面没出现过的Token,也有自己的输出列,可以被预测出来。
9.6 为什么训练还需要前面各位置的向量
你可能已经想到:
既然最终只用  ,那么前面的
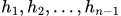 是不是多余的?
并不是。
首先,前面位置在各层产生的表示,会参与后续层对其他 Token 的注意力计算。
其次,训练阶段可以利用所有位置预测各自的下一个 Token。
例如:
| 当前位置的隐藏向量 | 对应的预测目标 |
|---|---|
 |  |
 |  |
|  |
 |  |
因果掩码保证了每个位置都不能提前看到自己的预测目标。
所以训练时可以并行计算多个位置的损失;推理时,前面的位置已有对应的 Token,我们主要需要预测尚未生成的下一个 Token,因此只使用最后位置的输出分布。
9.7 从五个位置的例子推广到任意长度
假设输入总共有  个 Token,经过所有 Transformer 层以后得到:
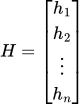
在推理时,我们取最后一行:

然后再做一次线性变换:
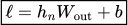
假设:

词表中有 50,000 个可能的 Token。
那么:
矩阵乘法后:
这意味着:从一个 512 维的上下文向量,计算出对词表中 50,000 个候选 Token 的预测分数。
再经过 Softmax:
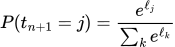
就能得到下一个 Token 的概率分布。
这里有一个你之前可能没有意识到的区别:
Attention 里面的 Softmax,是决定从已有 Token 获取多少信息;输出层的 Softmax,是决定下一个 Token 应该是什么。
它们虽然使用同一个数学函数,但作用完全不同。