
切换深浅主题
第 14 章:每生成一个 Token 后,接下来发生什么
现在参数怎样训练已经解释完,再回到使用模型。这里只发生新的前向计算与选择,通常不针对这次对话更新参数。
14.1 选出一个Token后,把它放回前缀
比如模型预测出了一个新的 Token  。
那么输入序列就由:

变成:

模型再计算第四个位置的最终隐藏向量  ,预测第五个 Token。
实际推理通常使用 KV Cache(键值缓存),保存前面 Token 在各层已经算出的 K、V,避免每次生成新 Token 时都重复计算整个前缀。
14.2 为什么使用最后一行
每一行 h_i 受训练目标约束,用于预测当前位置之后的 Token。前面各行预测的是已经出现在输入里的后续位置;最后一行对应尚未知的下一位置。因此标准续写取最后一行词表分布。
它能依赖整个允许前缀,不意味着它无损保存了全部原文,也不是把句子压缩成一个独立、永久不变的句子向量。下次生成时,新位置仍可读取历史各层 K/V。
14.3 概率怎样变成选择
贪心解码: 取概率最大编号。它最大化当前一步的概率,不保证整个输出序列的联合概率最大。
采样: 按概率随机选。即使概率较小也可能被选中。Softmax 本身只给分布,不执行抽样。
温度: 对  使用
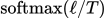 。较小 T 通常使分布更尖锐,较大 T 更平缓;
 不直接代入除法,而可讨论趋零极限。Top-k 或 top-p 还会截断候选并重新归一化。这些是解码规则,不是本次把模型训练了一遍。
14.4 KV Cache为什么能复用旧结果
在因果网络中,追加新 Token 不改变旧位置允许看到的前缀。参数固定、位置定义与计算配置不变时,旧位置各层 K/V 无需重新计算。保存它们,就能让新位置的 Q 读取旧 K/V 加上新位置自己的 K/V。
这依赖第8章的因果归纳性质。缓存要逐层保存,不是只保存最终向量。旧位置的中间表示在多层网络中早已参与构造后续所需的 K/V,并没有“只用最后一行所以前面都没用”。
窗口截断、位置重映射、参数改变等会影响缓存可复用条件。缓存通常以额外内存换取减少重复计算,也不消除新 Token 读取历史内容的代价。
14.5 怎样停止并变回文字
可因选中 EOS、达到长度上限或触发应用停止规则而结束。句号不自动等于结束。输出 Token 序列还要由 tokenizer 的解码规则变回可见文本,Token 与完整汉字、完整词语并非一一对应。
普通生成过程保持参数不变;上下文和缓存改变。把用户信息写进本次上下文,可以改变后续输出,并不等于本次进行了梯度训练。
14.6 训练、上下文适应与应用记忆
参数训练:损失反传后更新参数。上下文适应:参数固定,用本次上下文改变激活与预测。工程记忆:应用存储信息并在未来检索或插入上下文。三者可配合,但不能互相替代为同一个概念。