
切换深浅主题
第 10 章:用同一句话看训练和生成两种情况
现在输入、注意力、h与输出层都已经有了意义,可以把原问答中整句“患者服用华法林后出现黑便。”的训练和生成示例完整接上。这里的概率仍然是示意值,不是真实模型运行结果。
10.1 首先,把一句话转换成 Token
为了方便理解,假设模型将这句话切分成 7 个 Token(实际 Tokenizer 不一定这样切分)。
每个 Token 转换成向量,再组成矩阵:
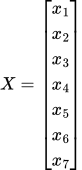
我们现在分别看两种情形。
10.2 训练阶段:模型已经有整句话作为标准答案
训练数据中已经存在:
患者服用华法林后出现黑便。
模型的任务是学习:给定前面的 Token,后面应该是什么 Token?
一次训练可以同时预测多个位置
| 当前已知前缀 | 要预测的正确 Token |
|---|---|
| 患者 | 服用 |
| 患者 服用 | 华法林 |
| 患者 服用 华法林 | 后 |
| 患者 服用 华法林 后 | 出现 |
| 患者 服用 华法林 后 出现 | 黑便 |
| 患者 服用 华法林 后 出现 黑便 | 。 |
| 患者 服用 华法林 后 出现 黑便 。 | 结束标记(示意) |
重点是:训练时可以把完整的句子一次性输入 Transformer,而不是必须分别运行七次。
但既然输入里已经有「黑便」,不就泄漏答案了吗?
这就是我们刚刚讨论的因果掩码  的作用。
当模型计算第 5 个位置「出现」的注意力时,只允许访问:
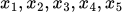
不允许访问:

因此虽然整个矩阵  包含「黑便」,但第 5 个位置的计算不能利用它。
这里要记住:第 5 个位置经过多层 Transformer 后得到的  ,就是用来预测「黑便」的。
假设模型预测错误了
假设输出层给出的概率为:
| 候选 Token | 模型预测概率(示意) |
|---|---|
| 呼吸困难 | 45% |
| 黑便 | 30% |
| 呕血 | 15% |
| 其他 | 10% |
正确答案是「黑便」,但模型给它的概率只有 30%。
于是计算交叉熵损失:
对于这个位置:
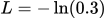
同样,训练还会对其他位置计算损失,再进行汇总。
然后才是真正的训练
通过反向传播,计算损失对参数的梯度:
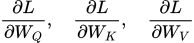
优化器根据这些梯度更新权重,例如以最简单的梯度下降表示:
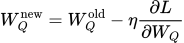
其他参数也类似。
通过大量训练,模型逐渐调整这些矩阵,使正确的下一个 Token 获得更高的预测概率。
还有一个容易忽略的地方:训练时即使模型错误地预测了「呼吸困难」,用于其他位置预测的输入仍然是训练数据里的正确 Token「黑便」。 这通常称为 Teacher Forcing(教师强制)。
10.3 推理阶段:模型不知道后面的正确答案
现在换成已经训练完成的 GPT。
你输入:
患者服用华法林后出现
注意,此时输入里没有「黑便」。
模型收到的 Token 是:
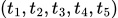
组成:

第一步:进行 Attention 运算
仍然计算:
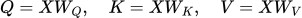
然后:
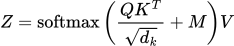
经过多个 Transformer Block,得到:
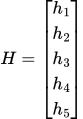
取最后一个位置:

第二步:预测下一个 Token
模型利用 计算词表中所有候选 Token 的概率。
例如,这次预测结果可能是:
| 候选 Token | 预测概率(示意) |
|---|---|
| 黑便 | 60% |
| 呕血 | 20% |
| 头晕 | 10% |
| 其他 | 10% |
模型根据解码策略选择一个 Token。
假设选择了「黑便」。
第三步:将生成的 Token 放回输入序列
新的序列是:
患者服用华法林后出现黑便
现在有 6 个 Token。
模型再次根据最后一个位置的隐藏向量预测后续 Token。
假设又生成「。」。
于是得到:
患者服用华法林后出现黑便。
但请注意,模型不一定会生成这句话。这里只是展示一种可能的生成过程。
整个过程中,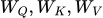 一直是训练完成后已经确定的参数,不会因为本次生成而更新。
10.4 把两种情况直接对比
现在我们专门研究「出现」后面生成「黑便」的这个位置。
| 训练阶段 | 推理阶段 | |
|---|---|---|
| 模型能看到的前文 | 患者服用华法林后出现 | 患者服用华法林后出现 |
| 数据中是否有正确答案「黑便」 | 有,但被因果掩码挡住 | 尚未提供 |
是否计算  | 是 | 是 |
是否计算  和 | 是 | 是 |
| 是否预测第 6 个 Token | 是 | 是 |
| 预测错误后 | 计算损失,更新参数 | 按解码策略生成 Token |
| 是否知道标准答案 | 是 | 否 |
| 是否更新 | 是 | 否 |
你应该注意到一件非常重要的事情:
对于完全相同的前缀,如果训练和推理使用的是完全相同的模型参数,那么在相同计算条件下,两者得到的下一 Token 概率分布也是相同的。
区别主要在于后续如何使用这个概率分布,而不是 Attention 采用了不同的数学公式。
10.5 如果推理时输入的已经是完整句子呢?
这也正是你最开始提出的疑问。
假设你直接输入:
患者服用华法林后出现黑便。
那么 GPT 不会再把「黑便」当成下一步需要预测的内容。
因为「黑便」已经属于输入。
它会计算整个输入序列最后位置「。」的隐藏向量  ,用来预测第 8 个 Token。
如果你输入的是:
患者服用华法林后出现黑便。请分析可能的原因:
那么模型就会从冒号之后开始生成内容,例如讨论消化道出血及抗凝相关出血风险。
所以实际上,ChatGPT 接收的不只是孤立的一句话,还可以接收系统指令、前面的对话历史、当前问题等共同组成的上下文序列。随后它从整个前缀的末尾继续生成回答。
最后再把 X、Z 和 W 的关系串起来
这是整个过程最容易混淆的地方。
你可以这样记忆:
 是模型长期学到的「规则」。
- 是这一次输入的内容。
- 是按照规则,从输入中动态整合出来的信息。
 是经过整个模型处理、用于预测下一个 Token 的最终表示。
而所谓训练与推理的区别,本质上就是:
训练:用已知的正确答案,调整规则 。
推理:使用已经学好的规则 ,预测未知的后续内容。
如果你接下来希望继续深入数学原理,我认为最重要的问题已经从 Attention 转移到了反向传播:模型究竟怎样根据「黑便」预测错误所产生的损失,反过来知道应该修改  中的哪些数字? 这一步才真正解释了神经网络的「学习」是怎样发生的。
10.6 最后再把 X、Z 和 W 的关系串起来
这是整个过程最容易混淆的地方。
你可以这样记忆:
- 是模型长期学到的「规则」。
- 是这一次输入的内容。
- 是按照规则,从输入中动态整合出来的信息。
- 是经过整个模型处理、用于预测下一个 Token 的最终表示。
而所谓训练与推理的区别,本质上就是:
训练:用已知的正确答案,调整规则 。
推理:使用已经学好的规则 ,预测未知的后续内容。
如果你接下来希望继续深入数学原理,我认为最重要的问题已经从 Attention 转移到了反向传播:模型究竟怎样根据「黑便」预测错误所产生的损失,反过来知道应该修改 中的哪些数字? 这一步才真正解释了神经网络的「学习」是怎样发生的。
10.7 几个容易混淆的条件,放在这里说明
第一,句号本身不是EOS。训练表中“句号预测结束标记”,要以数据确实追加了EOS为前提;若没有,就忽略最后没有下一目标的位置。
第二,标准下一个Token交叉熵训练并不需要真的先抽样错误答案。直接从完整分布取真实目标的概率即可。其他位置仍使用数据中的真实前文。
第三,训练可把输入设为t1到t6,标签设为t2到t7;也可输入七项再忽略最后目标。目标错开一位,才是这张训练表的要点。