
切换深浅主题
第 2 章:Q、K、V 从哪里来,WQ 又是什么
你问“这一步是在算WQ还是算q”,说明必须先分清规则与本次结果。下面保留原回答中三个阶段的拆分,但先补上Q/K/V为什么分成三个角色。
2.1 同一个输入,经过三个不同的变换
Transformer 不会直接使用原始  计算所有关系,而是先进行三个线性变换:

其中 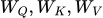 都是训练得到的参数矩阵。
你可以把它理解为:同一个向量经过三种不同的线性变换,得到三种不同用途的表示。
| 向量 | 英文 | 可以怎么理解 |
|---|---|---|
| Q | Query(查询) | 我需要寻找什么信息? |
| K | Key(键) | 我具有什么信息可供匹配? |
| V | Value(值) | 我实际可以传递什么信息? |
举个医学语言的例子。
当模型处理「黑便」时,可能需要关注「华法林」这个词,因为两者之间存在与出血相关的联系。
那么:
- 「黑便」的 Query 可能与「华法林」的 Key 高度匹配。
- 这种匹配会产生较大的注意力权重。
- 「华法林」的 Value 就会更多地参与「黑便」的新向量的构造。
这是机制上的示意,并不意味着模型内部真的有一个人为设定的「出血维度」。
这里用“黑便”读取“华法林”,说的是黑便已经作为输入出现之后的表示更新;若要在它尚未出现时预测它,应使用前一个“出现”位置的最终表示。这两个时刻不要混淆。
2.2 第一阶段:计算本次的 q、k、v
假设某个 Token 的原始向量是 。
首先通过矩阵变换:

这里有两类不同的东西:
- :模型通过训练学到的参数矩阵,在一次普通推理过程中保持不变。
 :根据当前输入计算出来的向量,会随着输入的 Token 及其表示改变。
因此, 是用于计算
 的矩阵,二者不是同一个东西。
2.3 一个小计算,看清 WQ 与 q 的区别
假设某行输入为:
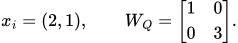
则 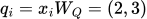 。如果输入变为
 ,WQ不变,q就变成
 。
所以WQ是一套可训练的数值规则;q是这次输入按规则算出的结果。训练更新的是WQ;下一次前向传播再用更新后的WQ算新的q。不是先单独“训练出一份固定Q”给所有输入使用。
2.4 第二阶段:使用 q、k 计算分数
这才是你选中的「Q 与 K 如何确定权重」那一步。
我们已经有了:

现在计算:
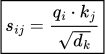
它表示第  个 Token 的 Query 与第
 个 Token 的 Key 的匹配分数。
这里没有计算新的 ,也没有计算新的 ,只是使用第一阶段得到的向量进行点积。
2.5 第三阶段:把分数变成比例
将分数  转换为:
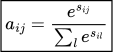
得到真正的注意力权重  ,然后计算:
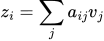
2.6 遇到下标时,按谁在读、从哪里读来理解
中,i是当前需要读取信息的位置,j是候选提供信息的位置。属于i, 属于j,表示i分给j的比例。
例如 是“出现”位置从“华法林”位置读回信息时所用的系数。它不是WQ里的第5行第3列,也不是“黑便”的输出概率。
下面先只看一个位置面对几个候选的情况,暂时不让整张矩阵掩盖每一步。