
切换深浅主题
第 4 章:dk 是什么,为什么要除以它的平方根
这一章把你连续追问的dk、方差定义、方差相加和缩放放在一起。先说明符号,再用原来的正负1例子;证明用到均值为0时,立即解释依据,不再让你跳到后面寻找。
4.1 dk先表示什么
 指的是 Key 向量(键向量)的维度,也等于 Query 向量的维度。
回顾 Transformer 中的注意力公式:
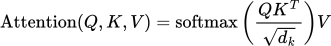
假设输入的每个 Token 是一个 512 维向量:

经过线性变换:

我们可以把 Query 和 Key 都映射到 64 维:

此时:

它们的点积为:
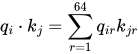
也就是 64 个乘积项相加。
因此需要除以:
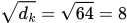
注意区分三个不同的维度
| 符号 | 含义 | 假设值 |
|---|---|---|
 | Token 在模型中的表示维度 | 512 |
| 每个注意力头的 Query、Key 维度 | 64 |
 | 每个注意力头的 Value 维度 | 64 |
如果有 8 个注意力头,经典配置中通常是:
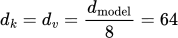
但这只是常见的设计选择,并不是数学上必须如此。
最重要的一点: 不是 Token 的数量,而是用于计算一次 Query–Key 点积的向量维度。
例如一句话有 20 个 Token,每个注意力头的 Key 是 64 维,那么:
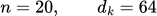
最终  的大小是
 ,而缩放因子仍然是
 。
4.2 先看缩放的理由,再把方差细节补全
前面为了说明 Softmax,故意省略了这一步。
实际 Transformer 并不是直接计算:

而是:

原因与高维向量的点积有关。
你知道二维点积是:
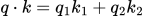
如果是 64 维:
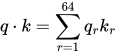
现在是 64 项相加。
假设这些乘积项大致独立,每项均值为 0、方差为 1,那么 64 项之和的方差就是 64,标准差是:

而如果只有 4 维,其标准差则是:

所以在这样的统计假设下,维度越高,点积结果的典型波动幅度越大,规模大约正比于  。
如果不缩放,Softmax 很容易得到特别极端的结果,比如:
过于极端的 Softmax 可能导致梯度很小,不利于训练。
因此,把点积除以 ,就能使其数值尺度相对稳定。
这是一个基于典型统计假设的解释,并不是说所有高维向量的点积都必然很大。
4.3 先不考虑 Transformer,假设有 4 个随机数
假设每个随机数  都有以下分布:
并且它们相互独立。
每一个随机数的期望为:
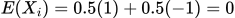
方差为:
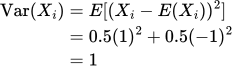
因此,每个随机数都是:

现在把 4 个随机数相加:
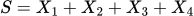
你可能直觉上认为:四个随机数的标准差都是 1,加起来之后标准差应该是 4。
但我们实际上可以把所有可能结果列出来。
总和  | 16 种组合中出现次数 | 概率 |
|---|---|---|
| −4 | 1 | 1/16 |
| −2 | 4 | 4/16 |
| 0 | 6 | 6/16 |
| 2 | 4 | 4/16 |
| 4 | 1 | 1/16 |
你会发现,虽然理论上可以取到  或
 ,但最常见的结果反而是 0。
原因很简单:随机的正负数会相互抵消。
我们计算这 4 个数之和的方差。
因为  ,所以:
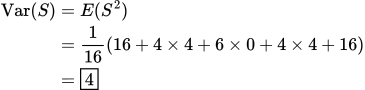
因此标准差为:
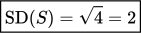
注意:虽然 4 个随机数相加可以得到最大值 4,但总和的标准差只有 2。
4.4 先补上你追问的方差定义
因为我们前面假设  和
 的期望都等于 0,所以方差的定义可以简化。
我们从方差(Variance)的定义开始。
方差的定义
对于任意随机变量  ,方差定义为:
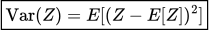
这里:
 :随机变量 的期望,也就是均值。
 :随机变量与均值的偏差。
 :偏差的平方。
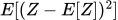 :平方偏差的平均值。
所以,方差就是随机变量相对于自身均值的平方偏差的期望。
为什么这里可以省略均值?
我们令:

代入方差定义:
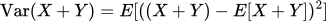
因为期望满足线性性质:
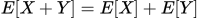
而我们之前假设:
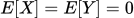
因此:
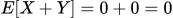
代回方差公式:
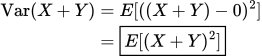
这就是那个等式成立的原因。
注意:这里根本不需要假设 和 独立。只要它们的和的期望为 0,就能这样简化。
如果均值不是 0 呢?
例如:

那么:
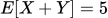
此时必须写成:
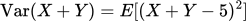
而不能直接写成  。
实际上,把方差定义展开,还可以得到一个常用的恒等式:
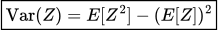
它对任何具有有限方差的随机变量都成立。
因此,当  时:
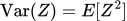
总结:方差并不总是平方的期望,只有均值为 0 时,二者才相等。
另外,你可以注意到两种性质所需的条件不同:
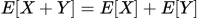 :不需要独立。
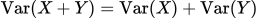 :需要
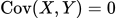 ,独立是保证这一点的充分条件,但不是必要条件。
这一区别正是理解 Transformer 中点积方差推导的关键。
4.5 为什么方差是直接相加的?
我们现在从数学上证明这个性质。
假设有两个独立随机变量  ,其期望都为 0。
那么:
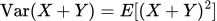
展开平方:
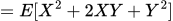
利用期望的线性性质:
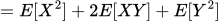
这里最关键的是:
如果 相互独立,那么:
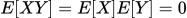
所以中间的交叉项消失了!
得到:
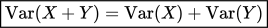
因此,对于  个相互独立、方差都是 1 的随机变量:
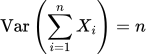
而标准差是方差的平方根:
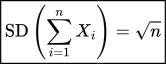
这里就出现了我们需要的平方根。
4.6 回到 Transformer 的点积
假设 Query 和 Key 都是 64 维:
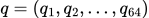
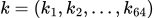
点积为:
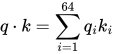
我们将每一项记为:

如果假设每个  都独立、均值为 0、方差为 1,那么:
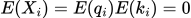
而且:
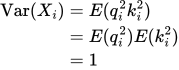
也就是说,每一个维度的乘积项,也具有均值 0、方差 1 的性质。
如果不同维度之间也相互独立,那么根据上一节的结论:
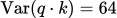
因此:
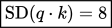
我们看维度不断增加时会发生什么。
由上述推导可见:维度越高,原始点积的标准差越大;但除以 之后,标准差在这一假设下就保持为 1。
要特别区分:
- 标准差为 8,不是说点积必然等于 8。
- 而是说点积围绕均值 0 的波动尺度为 8。
- 如果分布近似正态,那么约 68% 的点积结果会落在
 到
 之间。
4.7 为什么要除以 √64,而不是除以 64?
这时就很好理解了。
64 维时:
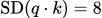
如果直接除以 64:
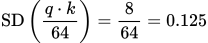
这样标准差反而会随着维度增加而不断减小。
但是如果除以 8:
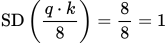
就回到了单位标准差。
因此 Transformer 使用:

目的不是让点积的值落在某个固定范围内,而是在上述统计假设下,使不同维度的点积分数具有大致相同的波动尺度,避免 Softmax 因输入分数过大而容易饱和。
4.8 还有一个可以联系你已有知识的地方:随机游走
你可以把每一个  或
 看成数轴上随机向左或向右走一步。
假设走 64 步:
- 如果始终往右走,位移可以达到 64。
- 但如果方向完全随机,很多步会彼此抵消。
- 最终位移的均方根是 。
这和点积中 64 个随机乘积项相加,具有相同的数学结构。
所以 的来源,本质上就是独立随机项求和时,标准差按平方根规律增长。
最后还有一个细节:这个推导依赖于各维度独立、均值及方差满足特定条件的假设。真正训练好的 Transformer 中,Q、K 的各维度并不一定严格独立或服从这种分布,因此除以 是合理的尺度调整方法,而不是能保证所有情况下方差都恰好为 1 的数学定理。
4.9 尺度为什么影响Softmax
把分数差放大,Softmax就更容易把比例集中到一个候选。例如(1,0)还会给第二项明显份额,而(100,0)几乎全部给第一项。
对比例 和分数
 求导,有:
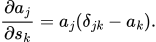
 在j=k时为1,否则为0。若一项接近1、其余接近0,这些导数就接近0,经过注意力比例传回的梯度可能变小。除以根号dk,是帮助控制输入分数尺度,而不是保证所有训练问题都被解决。
这个导数怎样从Softmax求出,第15章保留了商法则的逐步推导。这里不要求先学会矩阵求导。