
切换深浅主题
第 3 章:点积怎样一步步变成注意力比例
这里对应你说的“还是太快,不太好理解”。原回答后来把点积、取指数、归一化和加权分开讲,这个展开顺序保留下来。缩放因子的推导紧接在下一章。
3.1 先理解:为什么需要计算点积?
假设一句话里有三个 Token,我们希望知道当前 Token 应该更加关注哪一个。
首先,模型已经通过线性变换得到:
- 当前 Token 的查询向量
 (Query)。
- 三个候选 Token 的键向量
 (Key)。
为了方便,我们假设所有向量都是二维的:


你已经学过点积公式:
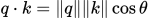
这里所有向量的模长都是 1,于是点积仅由夹角决定。
逐个计算:
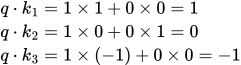
于是得到三个分数:
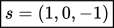
它们可以表示三种匹配程度:
| Key | 点积分数 | 在这个例子中的直观含义 |
|---|---|---|
 | 1 | 匹配程度较高 |
 | 0 | 匹配程度居中 |
 | −1 | 匹配程度较低 |
到这里,我们还没有涉及概率,也没有进行信息组合。
点积只是给出了一个分数,用于比较不同 Key 与当前 Query 的匹配程度。
需要注意,实际模型的 Q、K 不一定是单位向量,点积不仅由夹角决定。所谓「高分意味着更值得关注」,是模型通过训练学出的规则,而不是任何两个语义相近的向量天然都有高点积。
3.2 为什么不能直接拿 (1, 0, −1) 作为权重?
现在假设三个 Token 各自携带信息:
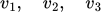
我们想构造:
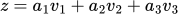
你最近学过凸组合,知道如果把三个系数解释为信息分配比例,应当满足:
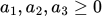
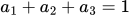
这样我们才能说:
「从第一个 Token 获取 60% 的权重,从第二个获取 30%,从第三个获取 10%。」
但刚才点积得到的:

有两个问题:存在负数,而且总和是 0。
不能直接将它理解成三个非负的信息分配比例。
因此需要一个额外的数学函数:
把任意实数分数转换成总和为 1 的非负权重,同时尽可能保留原来的高低顺序。
这就是 Softmax 的作用。
3.3 Softmax 分成两个步骤,其实很简单
我们仍然使用:
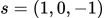
第一步:每个分数取指数
也就是计算  。
你可以先把  当作一个固定常数。

得到:
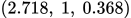
为什么这样做?
因为指数函数有几个非常适合这里的性质:
- 对任何实数,指数结果始终大于 0。
- 原来分数越大,指数结果也越大。
- 较高的分数经过指数变换后,会获得相对更大的权重。
因此,它既消除了负数,又保留了匹配分数的排序。
第二步:让三个数字的和等于 1
目前三个数字之和为:
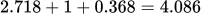
那就把每个数字都除以 4.086:
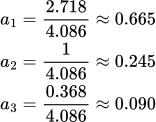
现在:
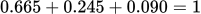
我们成功得到了三个凸组合系数。
如果把三个分数全部设为0。
这时 Softmax 会得到:

因为三个 Token 的匹配分数完全相同,所以它们获得同样的权重。
这说明一件很重要的事情:
Softmax 不是独立判断某个 Token 的分数够不够高,而是在多个候选 Token 之间进行相对分配。
3.4 现在才把它和凸组合联系起来
经过上面的计算,我们得到了:
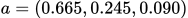
假设三个 Value 向量为:
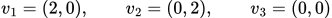
我们进行加权组合:
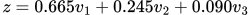
代入:
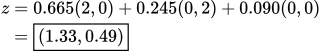
这时候就可以用你熟悉的凸包知识理解了。
因为三个权重全部非负,而且总和为 1,所以得到的新点  ,一定在
 的凸包内部。
这就是注意力机制中的信息整合过程。
注意:Q、K 负责计算权重,但最终被加权的是 V,而不是 Q 或 K。
3.5 为什么加同一个数不改变结果
如果把所有分数都加c,则分子分母都多了同一个因子 ,它会约去:
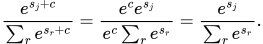
这说明Softmax使用候选之间的相对分数,而不是拿一个固定分数线判断是否重要。数值实现常先减去最大分数,利用同一性质避免指数太大。
注意,上面把比例说成“取多少信息”,是解释计算分工,不是已测量的语义贡献百分比。V的方向、大小和后续网络,也会影响最终结果。
原来两个候选的比例还满足:
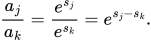
因此它们的分数相差1,权重之比就是e;所有分数一起平移,则这个比不变。