
切换深浅主题
第 13 章:补算一个小模型,看到梯度真正回到 WQ
原问答已经用一个标量算过更新。但“最终误差怎样真的传到WQ”仍然值得多算一小段。这里保留第二版的可核验小模型作为补充练习:不替换前面的一般公式,也不要求先看完这一章才能继续读生成过程。
13.1 先缩小教具,但不把数字与文字脱开
完整模型参数太多,不适合手算。我们做一个极小的教学模型,只留下“注意力 → 残差 → 输出 → 损失”这条主线。FFN、归一化和位置编码暂时不放进去;因此它不是完整GPT。
为了仍然对应那句填空,这一章专门使用一个只有三项的玩具词表:
| 简写 | 这一项代表的文本 |
|---|---|
| A | 患者服用华法林后 |
| B | 出现 |
| C | 黑便 |
把一整段前文当成一个Token,只是为了缩成两个输入位置。这是本章特设的玩具分词,和前文七块分词不同,也不是说合并以后与原模型计算等价。 本章不处理句号或结束标记。
输入是A、B,即“患者服用华法林后出现”;目标是C,即“黑便”。注意力要让“出现”这个位置读取前文A,再由它的最终向量预测C。
13.2 先列出本次所有参数
给三项Token各指定一个二维嵌入。把这张表叫E:
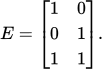
三行依次对应A、B、C。于是输入A、B查出  、
 ,按行排列:
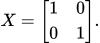
指定匹配变换和内容变换:
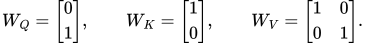
WQ把二维输入变成一维q,WK把二维输入变成一维k。WV在这个初值下不改变向量。q/k只有一个坐标,所以本例dk=1,缩放因子也是1。
再设注意力输出投影WO也为二维单位矩阵,并指定词表输出矩阵:
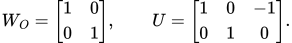
U三列依次给A、B、C打分。这里没有偏置,E与U也不共享。以上参数都是为了方便核验而指定的起点,不是已经学会医学知识的一套数。
13.3 逐行算 Q、K、V
对第一位置A, :
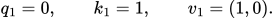
对第二位置B, :
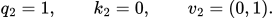
为什么第二位置q等于1?就是 乘WQ那一列,得到 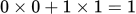 。每一个数都来自普通乘加。
现在考察第二位置“出现”。它对前文A的分数是  ,对自己B的分数是
 。
所以它需要分配的是两个分数 。Softmax给出:
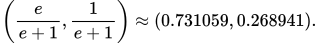
为了后面算式短一点,把这两个数暂叫a和c。a不是Token A,c也不是Token C;它们只是两个比例:a约0.731059,c约0.268941,而且a+c=1。
13.4 取内容,再加回原表示
第二位置读到的结果是:
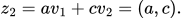
再经过WO投影。因为本例WO恰好是单位矩阵,投影不变。与第二位置原输入 相加:
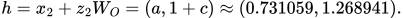
这里h就是本章小模型的最终向量。请注意:第一个坐标约0.731059不是“黑便概率”,第二个坐标也不是另一个Token概率。h仍是给输出层读取的两个数。
第一位置只能读自己,权重恒为1。若同时把两行写出,注意力比例表为:
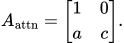
加上下标attn是为了把这张表与词表中的Token A区分开。
13.5 终于得到三个候选的概率
把h乘U:
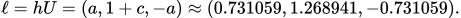
第三项是C、“黑便”的分数。当前参数居然给它负分,但负分没有问题:logits只是相对分数,接下来才变概率。
对三项取指数再归一化,得到:
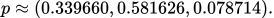
即A约33.97%,B约58.16%,C“黑便”只有约7.87%。输入中没有C,也不妨碍输出层给它打分。
训练目标是C,所以损失为:
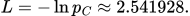
这一次概率不是凭空指定的30%。它从输入、投影、比例、内容、残差与输出矩阵逐步算出来。
13.6 先看损失怎样要求输出分数改变
对“Softmax加负对数损失”,可以推导出一个非常实用的结果:
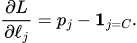
符号  的意思是:如果当前候选j正是目标C,取1,否则取0。推导在第15章,不需要凭记忆接受。
代入本例,三个分数的梯度约为:
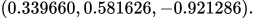
这说明:若能独立改这三个分数,降低A、B分数,提高C分数,会在当前位置附近降低损失。但它们并非独立参数,而是由h和U算出,所以还要继续求到h与U。
13.7 再看误差怎样传到“读多少”
U第一行是  。h第一个坐标增加一点,会让A分数同量增加、C分数同量减少。因此L对h第一坐标的导数是:
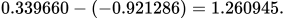
U第二行是  ,所以h第二坐标只直接影响B分数,对应导数是0.581626。
于是h的梯度约为 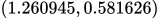 。由于本例的残差直连和WO初值很简单,这份梯度也沿z2向前传。
而z2是  。若先把a、c当成两个独立变量,增加a就沿 方向改变z2,对损失的影响率是1.260945;增加c则沿 方向改变,影响率是0.581626。
所以损失对两项混合比例的梯度,是这两个数。到这里,我们已经从“C预测得太低”,追到了“怎样的内容混合更能降低损失”。
13.8 比例互相牵制,不能各自随便改
a与c经过Softmax产生,必须相加为1。如果提高第一个匹配分数,a会增加,c会相应减少。因此要把这两种影响同时算进去。
对分数  ,两项Softmax中有:
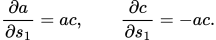
把两条影响加起来:
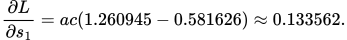
同理,第二个分数的梯度约为−0.133562。这里终于出现了“匹配分数该往哪个方向变”的数值。
注意,它不是简单地说“让看起来有关的前文权重越来越高”。这个方向取决于当前V内容、输出U和整个损失,不是人为指定的语义关系。
13.9 现在才到 WQ
本例q2来自第二行输入乘WQ,而两个分数是:

求q2的局部影响时,把当前k视为给定,得到:
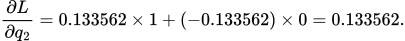
再看WQ第二个元素,记为w。因为输入第二行是 ,有 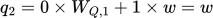 ,故损失对w的导数也是0.133562。
取学习率0.1,它从1更新为:
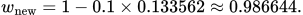
至此,“预测错了怎样影响WQ中的一个数”已经走通:输出误差 → h → 内容比例 → 匹配分数 → q → WQ。
13.10 不是只改这一个数,而是共同更新
同样的链式法则也能算出WK、WV、WO、U和输入E的梯度。第15章列出矩阵规则,配套程序保存全部24个参数元素的结果。
例如,U第二行、C列最初为0。它的梯度为:
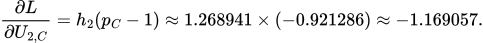
注意这里  是本章二维h的第二个坐标,不是“第2位置的向量”。因为本节已经固定最后位置,只对向量内部坐标编号。写明这一点,是为了不把位置下标与坐标下标混用。
学习率0.1时,这个输出参数从0增加到约0.116906。输入表示的数也会更新,Q/K/V的各变换同样参与。
所有梯度先基于同一套旧参数算出,再一起执行更新。不能先改U,再拿新U去拼接旧前向的梯度,那是在混用不同计算点。
13.11 全部更新后,再跑一次看看
使用学习率0.1联合更新所有可训练矩阵,再从查表开始重新计算:
| 观察的量 | 更新前 | 更新后 |
|---|---|---|
| “出现”读取前文A的比例 | 0.731059 | 0.713748 |
| 输出“黑便”的概率 | 0.078714 | 0.171807 |
| 正确目标损失 | 2.541928 | 1.761382 |
目标概率从约7.87%提高到17.18%,损失降低。但“黑便”还不是概率最大的候选,一次训练不必立刻答对。
读取前文A的比例反而下降了。说明训练可以通过同时改变输入表示、传递内容和输出打分来进步,不是“把每条看起来相关的注意力都加大”。
这个小模型共有24个参数元素。解析梯度与中心差分逐项核对,最大绝对误差小于  。这支持本例计算与程序实现一致,不等于证明真实模型学到了医学知识。
想核查数值,可以打开全部参数和梯度(本地资料)或运行程序(本地资料)。正文显示值经四舍五入,程序始终使用完整精度。