
切换深浅主题
第 8 章:没有掩码会怎样,怎样防止偷看未来
你说“没有M,每个词都会联系其他词吧”,这个判断正是理解掩码的入口。先看没有限制的情况,再看为什么下一个Token训练必须限制。
8.1 没有 M:双向注意力(Bidirectional Attention)
计算:
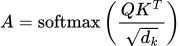
得到一个  的注意力矩阵。
可以看到:
- 没有
 :全部 25 个位置都可以参与注意力计算。
- 有因果掩码 :只有主对角线及其下方的 15 个位置可以参与。
8.2 既然如此,为什么 GPT 要加 M?
关键在于 GPT 的训练目标是预测下一个 Token。
例如:
患者服用华法林后出现____
我们希望模型根据已有内容预测后面的词。
假设训练数据的完整句子是:
患者服用华法林后出现黑便。
如果不使用因果掩码,在训练时,当模型使用「出现」位置的隐藏向量预测「黑便」时,它可以直接关注后面的「黑便」。
这就相当于预测答案之前,已经提前看到了答案。
训练过程会发生信息泄漏(Information Leakage)。
所以 GPT 加入:
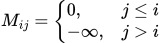
使未来位置的注意力权重严格等于 0。
这样,第  个位置的隐藏向量只能依赖前 个 Token:
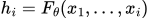
就可以用它预测第  个 Token,而不会提前看到正确答案。
8.3 那没有 M 的 Transformer 就没有用吗?
当然不是。
例如 BERT 就主要采用双向注意力。
如果任务是理解一整句话,而不是逐个预测后面的词,那么同时利用前后文通常很有帮助。
比如:
他在银行办理了贷款。
如果我们希望理解「银行」的意义,后面的「贷款」也能提供有用的信息。
BERT 可以让「银行」同时关注前后的 Token,而 GPT 的因果注意力不允许这个位置关注后面的「贷款」(但 GPT 在处理最后一个位置时,仍然可以整合整句话的信息)。
所以两者并不是谁绝对更高级,而是对应不同的计算约束和训练任务。
最后要补充一个精确的数学细节:无掩码时,各个位置的 Softmax 权重通常都严格大于 0,因此所有 Token 在数学上都会参与加权;但这不意味着它们具有同样的重要性,有些权重可以非常接近 0。
8.4 用三个位置把它算成一张表
例如:
患者 服用 华法林
为了简化,假设这句话恰好分成三个 Token:

其中:
 :患者
 :服用
 :华法林
现在我们对整个矩阵  进行 Self-Attention:
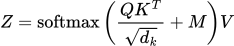
这里多了一个 ,它就是因果掩码(Causal Mask)。
它的作用是:每个 Token 只能获取自己以及自己之前的 Token 的信息,不能看未来。
8.5 看最后一行怎样读取完整前缀
假设经过 Softmax,得到:
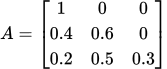
这是一个假设的注意力矩阵,不是真实模型的计算结果。
你注意最后一行:
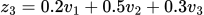
这说明,虽然  对应的是「华法林」这个位置,但它不再只依赖于「华法林」,而是同时整合了「患者」「服用」「华法林」的信息。
这就是为什么最后一个位置如此重要。
8.6 为什么叠很多层也不能绕路偷看
先看第一层:位置i只读取j≤i的输入,因此只可能依赖前i个Token。假设上一层每个位置j也只依赖前j个Token,那么位置i下一层读取的那些j≤i,仍然只携带前i个Token的信息。
FFN、残差和逐位置归一化不引入别的位置,所以逐层归纳后,最终h_i仍只依赖前i个Token。这个论证需要所有跨位置操作都遵守限制;若另外偷偷做全句汇总,就不能照用。
为写得精确,可以不把负无穷当普通实数,而直接规定:只在允许位置集合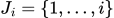 中做Softmax,其他系数设0:
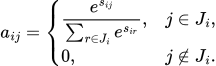
允许读取自己,保证每行至少有一项。数学上无掩码且分数有限时各权重严格正,但可能极小;实际浮点计算还可能下溢为0。