
切换深浅主题
第 7 章:注意力以外还有什么,为什么要一层层处理
注意力负责不同位置之间的信息交换,但完整Transformer不止这一步。这里保留原文中FFN、残差、位置和多层复合的解释,只补清它们怎样接起来。较细的归一化导数放在第15章,不挡住这条主线。
7.1 注意力只是一个Block的一部分
到目前为止,我们只解释了注意力。
真正的 Transformer Block 还有其他结构。
这里有两个你尚未重点接触的概念,但它们并不复杂。
前馈网络(Feed-Forward Network)
注意力负责不同 Token 之间的信息整合。
但整合之后还要对每个 Token 自身的特征进行加工。
一个经典的 FFN 可以写成:
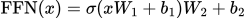
其中  是非线性激活函数,例如 ReLU 或 GELU;现代模型也经常使用门控结构。
从你熟悉的线性代数角度看,它相当于:

为什么要加入非线性?
因为如果始终只有固定的线性变换:
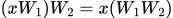
多个线性变换仍然可以合并成一个线性变换。
加入非线性函数后,整体一般就不能简化成一个矩阵乘法,能够表达更复杂的关系。
残差连接(Residual Connection)
其基本形式是:
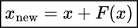
也就是把模块计算的新信息加到原信息上。
这样提供一条原输入的直连路径,通常有助于深层训练与梯度传播;并不保证任何情况下信息都不丢失。
这也是为什么我前面特别强调:
只有注意力头中的  是凸组合,整个 Transformer Block 的输出一般不再局限于原始 Value 的凸包。
因为后面还有线性投影、残差相加和非线性变换。
7.2 顺序信息怎样进入模型
你可能已经发现一个问题。
单纯从:

来看,在没有位置编码、也没有位置相关掩码时,改变Token排列会相应重排注意力输出,结构本身不提供顺序标签。因果掩码已引入方向约束,不能把无掩码结论直接照搬。
比如:
「医生治疗患者」与「患者治疗医生」
词语相同,但意义不同。
Transformer 因此需要位置相关的信息(Positional Information)。
经典的一种做法是:

其中  是表示位置的向量。
现代语言模型也常使用 RoPE(Rotary Position Embedding),将位置信息引入 Q、K 的计算。
你之前学过旋转矩阵,可以把 RoPE 看作一个很好的进阶理解对象:它通过与位置有关的旋转,让注意力分数反映相对位置信息。
7.3 普通的加权平均,与 Attention 有什么本质区别?
假设有三个向量:

最普通的平均:
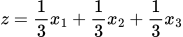
稍微复杂一点,可以设置不同的固定权重:
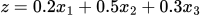
但是不管输入是什么,这三个系数始终不变。
而 Attention 不一样:
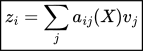
注意这里的:

权重是输入  的函数。
也就是说,模型不是简单地执行一个事先规定的加权平均,而是根据这一次的输入,现场计算应该采用怎样的加权系数。
这就是核心差别:模型能根据当前任务和上下文,改变信息整合的方式,而不需要人提前指定每个词应该关注谁。
7.4 从线性代数来看,它已经不是普通的线性变换了
你之前学过:

给定矩阵  ,这是一个固定的线性变换。
我们将 Transformer 的注意力公式完全展开:


代入:
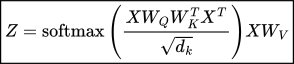
你仔细观察它。
其中 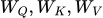 是训练得到的固定矩阵。
但是中间出现了:
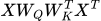
这意味着注意力分数取决于输入向量之间的两两相互作用。
再经过非线性的 Softmax,得到:

最终:
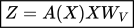
与普通的  不同,这里的
 并不是事先固定的矩阵。
所以,虽然一次注意力计算的最后一步是加权平均,但整个从 到  的映射一般是非线性的。
这就突破了固定线性变换只能按照固定规则处理数据的限制。
7.5 为什么堆叠几十层、上百层会产生更复杂的能力?
假设最开始每个 Token 只有比较基础的信息。
第一层 Attention:
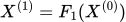
让它们整合其他 Token 的信息。
第二层:
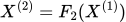
注意,这次输入已经不是最初的词向量了,而是经过第一层上下文整合的新向量。
这意味着第二层不仅能关注原始词语,还能进一步处理第一层已经提取出的关系。
第三层再继续:
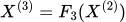
最终形成:
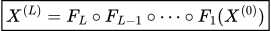
这就和你之前学习过的复合映射联系起来了。
可以想象一个医学场景:
患者使用抗凝药物后出现黑便,血红蛋白由 120 g/L 降至 75 g/L。下一步应该考虑什么?
某些注意力头或中间表示可能整合出药物与症状的关系,其他部分可能捕捉血红蛋白变化,再通过后续层将这些信息进一步结合。
需要强调,这只是概念示意,并不是说真实模型严格按照「第一层识别药物、第二层判断出血、第三层推理」这样的人工步骤运作。
而且,Transformer 每一层还有前馈神经网络、残差连接等结构,因此整个网络远不止反复进行凸组合。
7.6 最值得惊讶的其实是:这些规则并不是人写进去的
这一点可能比注意力公式本身更重要。
我们并没有手动告诉模型:
- 遇到「华法林」,要联系「出血」。
- 遇到「血红蛋白下降」,要考虑失血。
- 遇到「它」,需要识别它指代前文的什么。
我们只是设定了 Transformer 的计算结构,然后通过大量训练数据,优化 及其他参数。
模型在不断降低预测误差的过程中,逐渐学会了如何组织中间表示、匹配相关信息、组合不同位置的信息。
不过也不能据此直接认定模型具有与人类相同的理解或推理机制。注意力本身只是计算工具,复杂能力来自注意力、非线性网络、训练目标、数据以及规模等因素的共同作用。
7.7 归一化、残差与完整一层的关系
前面讲了模块用途,再明确一种常见排列。令X是当前层收到的整句表示,MHA表示多头注意力,LN表示逐位置的LayerNorm:
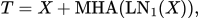
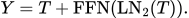
先归一化,算注意力,加回X,得到T;再归一化T,过FFN,加回T,得到Y,送进下一层。这叫Pre-LN。原始2017年论文用的是子层相加后再归一化的Post-LN,不要把这两种顺序当成同一精确配置。
LayerNorm只在同一位置的坐标里取均值和波动尺度。例如(1,2,3)先减均值2,得到(−1,0,1),再缩放。它不需要未来位置的数。完整公式和残差梯度依据仍保留在第15章。