
切换深浅主题
第 6 章:把逐个向量的计算写成矩阵,再变成多头
前面我们逐个q与k计算,再逐个v加权。现在才把这些运算装进矩阵,说明一次处理整句时每一行仍在做同样的事。大写字母只是把已经理解的计算合在一起。
6.1 先看前五个位置怎样同时得到五个新向量
这里用前五块“患者、服用、华法林、后、出现”作输入。下面的5×5只表示这个输入长度;完整句子包含七块,长度变化后矩阵的行数与列数相应变化。
我们已经知道:
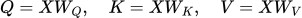
假设输入 5 个 Token,每个注意力头的 Q、K 都是 64 维。
那么:
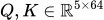
接下来:
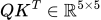
也就是说,模型计算了一个  的匹配分数矩阵。
经过缩放、因果掩码和 Softmax,得到注意力矩阵  。
下面用一个假设的权重矩阵展示它的结构。
最终:

这里的  不只是一个向量,而是一个矩阵:
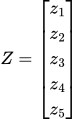
也就是说,输入整句话的五个向量,经过注意力计算,得到五个新的向量。
它们随后还会经过输出投影、残差连接、前馈网络等处理,进入下一个 Transformer Block。
6.2 一次矩阵乘法怎样完成全部点积与组合
你之前也讨论过矩阵乘法能够把大量向量运算合并进行。
假设输入有  个 Token:

投影后:
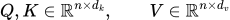
那么:
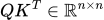
这个矩阵中的第  行、第
 列,就是:
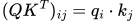
也就是说,一次矩阵乘法就计算了每一个 Token 对其他所有 Token 的匹配分数。
接下来,对每一行使用 Softmax:
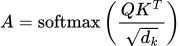
再做一次矩阵乘法:

把整个过程合并:
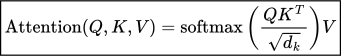
这是 Transformer 最经典的一条公式。
注意它的几何含义:
 :计算点积,决定权重。
- Softmax:把每一行变成非负且和为 1 的系数。
 :逐行构造 Value 的凸组合。
你可以把注意力矩阵 理解为一个由当前输入动态生成的加权组合矩阵。
这点很重要:
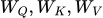 是训练后相对固定的参数,而 会随着每次输入的文本发生改变。
6.3 把矩阵乘法展开一项,就能核对
 第i行第j列为:
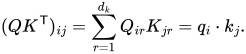
r在这里遍历向量坐标,i/j遍历输入位置。接着:
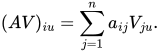
u是输出向量中的一个坐标。让u遍历全部坐标,得到的正是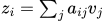 。因此矩阵写法与逐向量计算严格相同。
6.4 为什么还需要多头注意力
假设输入:
患者服用华法林后出现黑便,血红蛋白明显下降。
模型可能同时需要识别不同种类的联系:
- 药物与不良反应的联系。
- 症状与实验室检查的联系。
- 句法结构中不同词语之间的联系。
如果仅有一个注意力头,那么每个 Token 就只有一套 Q、K、V 变换。
Transformer 采用多个不同的投影矩阵:
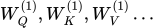
更准确地写,各头有各自的 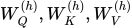 。
每个头独立计算:
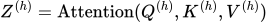
最后拼接并进行线性变换:
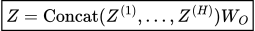
这就是 Multi-Head Attention(多头注意力)。
可以把它类比为多个不同的坐标投影方式,各自提取信息后再重新整合。但各头并不保证严格对应某种可解释的语法或医学关系。
6.5 拼接后为什么还要乘 WO
设有  个头,每头分别计算
 。拼接与投影是:
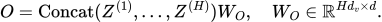
拼接后是  ,乘
 回到
 ,才能与原输入相加。多头允许多个混合分布同时存在,不要求“药物头”“语法头”这样人为固定的语义分工。