
切换深浅主题
第 5 章:为什么还要乘 V,得到的 z 有什么用
现在你已知道比例从哪里来。但你原来的追问还没有解决:“为什么又乘上V?”以及“x变成z,到底有什么意义?”下面沿用原问答的两层解释:先区分比例与内容,再说明上下文表示的用途。
5.1 先回想你熟悉的凸组合
先不考虑人工智能。
假设三维空间中有三个向量:
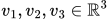
我们构造一个新向量:
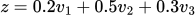
你已经知道,因为:
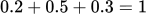
而且每个系数非负,所以  是三个向量的凸组合,必然落在它们构成的凸包内。
Transformer 的注意力机制,在很大程度上就是做这件事情:
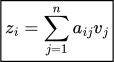
其中:
 :第
 个词所提供的信息向量。
 :第
 个词分配给第 个词的注意力权重。
 :第 个词综合其他词的信息后,得到的新向量。
并且:
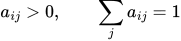
因此,单个注意力头的每一个输出向量,都是对应 Value 向量的凸组合。
这就是整个架构最值得首先理解的地方。
前两章已经解释这些比例怎样算出,现在重点看被组合的Value和结果z。
5.2 假设我们只有 Q 和 K,没有 V
例如一句话:
患者服用华法林后出现黑便。
假设现在模型正在处理「黑便」这个 Token,需要从前面的 Token 中获取信息。
第一步,利用「黑便」的 Query 和其他 Token 的 Key 计算匹配分数:

第二步,经过 Softmax,假设得到以下注意力权重:
| Token | 注意力权重 |
|---|---|
| 患者 | 0.1 |
| 服用 | 0.1 |
| 华法林 | 0.6 |
| 黑便 | 0.2 |
这意味着对于当前这个注意力头,「华法林」获得最高的注意力权重。
但是你注意到没有?
我们现在只有 0.1、0.1、0.6、0.2 这四个数字。
它们只能告诉我们应该给哪个 Token 分配更多权重,并不能直接告诉我们要从这些 Token 获取什么信息。
因此需要第三种向量: 。
5.3 V 的作用:提供实际被组合的信息
假设每个 Token 都有一个 Value 向量:

那么我们就可以按照刚才计算出的权重进行加权求和:
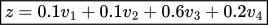
它的意思是:
当前「黑便」这个 Token 的新表示,整合了其他 Token 的信息,其中「华法林」的 Value 所占的权重最大。
这正好对应你之前学过的凸组合。
注意:这里所谓的信息并不是直接把「华法林」这个词复制过去,而是组合它经过线性投影得到的数值向量。
5.4 为什么不直接拿 K 来加权,而要另外计算 V?
这是更深层的问题。
实际上,从纯数学上讲,完全可以设计一种注意力机制,直接对  加权:

但是标准 Transformer 并不这么设计,而是另外引入:


原因是我们希望把两个任务分开:
- K 负责匹配: 这个 Token 是否与当前 Query 相关?
- V 负责传递: 如果相关,这个 Token 应该向当前 Token 提供什么信息?
这样,模型可以分别训练  和
 ,不必要求用于判断相关性的特征与用于传递的特征完全一致。
你可以用一个数据库检索的类比来理解:
假设你想查找某种药物。
- Query:你输入的检索条件。
- Key:数据库用来匹配检索条件的索引。
- Value:匹配之后返回的药物信息。
你不是为了拿到索引本身,而是为了获取索引对应的内容。
5.5 把点积、缩放、Softmax和V连起来再手算一次
假设某个 Token 的 Query 为:

三个 Key 为:
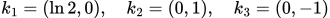
取  ,那么缩放后的点积分数为:
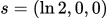
Softmax 之后:
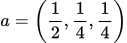
现在假设三个 Value 是平面上的三个点:
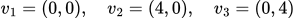
那么注意力输出:
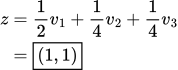
可以看到,我们只做了三件事:
- 使用点积确定匹配程度。
- 使用 Softmax 把分数转换成凸组合系数。
- 使用这些系数对 Value 进行加权平均。
这三个操作就是 Scaled Dot-Product Attention 的核心。
5.6 假设没有 Attention,会怎样?
例如:
我刚吃了苹果。
我投资了苹果。
假设我们单独考虑「苹果」这个 Token。
最初通过 Embedding 得到:

在这两个句子里,「苹果」这个 Token 的初始词嵌入可以是完全相同的。
于是出现问题:
同样的向量,怎么区分第一个是水果,第二个是公司?
如果我们只对这个向量进行固定的线性变换:

那么只要  相同,输出就相同。
也就是说,它无法根据其他词语区分语境。
5.7 Attention 产生的 z 就是为了解决这个问题
对于「苹果」这个 Token,我们计算:
在第一句话中,模型可能更多地从「吃了」等位置提取信息。
在第二句话中,模型可能更多地从「投资了」等位置提取信息。
因此,虽然初始的 相同,但由于其他 Token 不同,得到的  也可以不同。
这就是 Attention 的价值:让一个 Token 的表示受到上下文的影响。
5.8 但 z 到底是什么?它还是一个普通的向量吗?
是的。
例如:
它仍然只是一个高维向量。
你可能会进一步问:
这些数字有什么实际意义?0.2 代表水果吗?−0.7 代表公司吗?
通常不是。
Transformer 并没有预先规定每一维必须对应一个具体概念。语义信息可以分布在许多维度中,而且一个维度也可能参与表示许多不同的特征。
的价值不在于人类能够直接读懂它,而在于后续网络能够利用它。
例如,模型可以通过后面的层,把新获得的上下文信息与当前 Token 原有的信息结合起来。
5.9 实际上 z 还不是最终输出
这里需要纠正一个容易产生的误解。
Attention 计算:
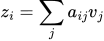
得到的 是一个注意力头的信息聚合结果。
经过多头拼接、输出投影之后,在常见的残差结构中,还会与原来的输入相加。
用单头简化表示:
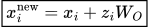
假设采用行向量约定,并令矩阵维度匹配。
你可以理解成:
这个新向量再进入后续的神经网络和 Transformer Block。
经过多层处理后,GPT 最终利用最后位置的隐藏向量  计算下一个 Token 的概率:
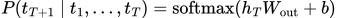
这里的输出才真正用于生成语言。
5.10 所以,从数学上看,z 的意义究竟是什么?
你可以把它理解成一种依赖于上下文的信息更新量。
普通线性变换:

只依赖于  。
而 Attention:
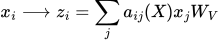
不仅依赖于 ,还依赖于其他  。
因此,原本彼此独立表示的 Token,现在可以相互传递信息。
这使模型能够建立词语之间的联系,而不只是逐个处理词语。
但也必须强调:数学上仅仅计算出 ,不保证它就包含有用的语义。只有经过训练,使整个网络能够利用这些向量降低预测误差时, 才真正具有功能上的意义。
5.11 这里的“有用”需要训练来建立
即使参数随机,也能照公式算出z,但它未必对预测有用。我们不是看见z里出现某个神奇坐标,就宣布模型理解了语言;而是后面会看到,它怎样被输出层利用,以及训练怎样改变产生它的参数。
只对归一化后的注意力组合而言,系数非负、和为1,所以属于当前Value的凸包。多头投影、残差与FFN不受同一个凸包约束;训练时若对系数做未重新归一化的dropout,当次组合也不能直接套用和为1的结论。
5.12 再看一遍标明分工的完整Attention公式
其中:
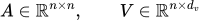
矩阵乘法:

得到:

这意味着,每个 Token 都得到一个新的向量表示。
最终记住一句话:Q 用来提问,K 用来匹配,V 用来提供答案所需的信息;Softmax 决定每份信息占多大权重。
而你已经理解的凸组合,恰好就是  这一步的数学本质。