
切换深浅主题
第 16 章:按原来的问题回查,以及来源与检查说明
这里按原来的提问顺序回查本版对应位置。正文按理解所需的先后重新排列,回查表仍保留你的提问链。
16.1 原始16轮问题的去向
| 原来的问题 | 本版位置 |
|---|---|
| 1 用我会的知识解释架构 | 输入与任务、整个Block |
| 2 点积转权重这里太快 | 保留原来的两步Softmax展开 |
| 3 为什么64项标准差是8 | 正负1例子与一般推导 |
| 4 为什么方差等于平方的期望 | 方差定义紧接在推导前 |
| 5 dk到底是什么 | 先定义坐标数再解释缩放 |
| 6 这一步是在算WQ还是q | 规则、本次结果与三个阶段 |
| 7 为什么又乘V | 匹配比例与传递内容 |
| 8 这有什么高级的 | 动态混合和多层复合 |
| 9 x变成z有什么意义 | 上下文表示与后续用途 |
| 10 一句话输入,训练还是输出 | 整句矩阵和阶段区别、同句对照 |
| 11 继续:为何用最后一行预测 | 最后位置与输出层、生成循环 |
| 12 没有M就可以读所有位置吧 | 双向与因果约束 |
| 13 用这句话展示训练和输出 | 原完整示例 |
| 14 解释损失、偏导与参数更新 | 原单参数推导和矩阵解释、补算WQ |
| 15 还得有一个预测函数吧 | h到分数到概率 |
| 16 输出层单独训练还是一起 | 联合目标、共享参数与输入梯度 |
16.2 这一版怎样保留原文,怎样作修正
本版以原分享问答的可见正文为底稿,保留其中逐步解释、例子和推导,主要调整顺序、统一符号、补必要衔接。相同公式的重复出现可以合并,但不以“容易理解”为理由删除推理环节。
修正的地方主要是:行向量与列向量约定、固定教学分词、苹果例子对未来词的依赖、句号与EOS的区别、权重共享不是求逆,以及示意分数不能当作真实模型测量。注意力比例也不直接等于最终答案的因果贡献。
原对话有几处交互图。本文把它们改为嵌入的静态图或明确表格,正文公式与解释保留;原始页面和可见正文仍一并存档。
第一版增加的矩阵反传与归一化公式留在补充章,不要求主线先建立一整套新理论。第二版的小模型也作为补充核验,而不代替原来易懂的单参数例子。
16.3 与你已有数学知识的对应,保留原来的整理
| 你已掌握的数学概念 | Transformer 中对应的结构 |
|---|---|
| 向量与坐标 | Token Embedding |
| 矩阵乘法、线性变换 | Q、K、V 投影 |
| 向量点积 | Query–Key 匹配分数 |
| 凸组合、凸包 | Attention 对 Value 的加权整合 |
| 矩阵按行运算 | Softmax 权重归一化 |
| 多种坐标投影 | Multi-Head Attention 的部分直觉 |
| 非线性函数 | FFN 中的激活函数 |
| 复合映射 | 多个 Transformer Block 堆叠 |
| 函数极值、偏导数 | 损失函数和梯度优化 |
最后再给你一个更抽象、但很重要的理解:
你以前研究的几何变换,大多是在研究一个已经给定的映射  ,例如
 ,并分析它的性质。
而在 Transformer 中,我们考虑的是一个参数化映射:
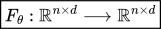
它的参数  包含众多矩阵,而这些矩阵不是由人事先指定的,而是通过训练数据优化得到的。
其中注意力机制还有一个非常特别的性质:它的加权矩阵  也是由输入
 动态决定的。
所以注意力部分可以抽象成:
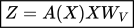
这里 的每一行都是一组凸组合系数。
这和普通固定矩阵变换  最大的区别之一,就是注意力的混合系数本身依赖于输入。
如果只记住一个数学本质,我希望是这个:
Transformer 利用可学习的线性投影和点积,为每个 Token 动态构造一组凸组合系数,让不同 Token 交换信息;然后通过非线性变换、残差连接和多层复合,形成复杂的语言表示。
你已经理解了其中最重要的线性代数部分。接下来最值得深入的其实是:为什么  这样一种看似简单的向量运算,经过多层复合之后,竟然能够表现出推理和语言理解能力? 这就涉及非线性、表示学习和模型训练的本质了。
16.4 原始来源与参考资料
分享来源:解释Transformer架构。本地可查看原对话正文(本地资料)与读取核对报告(本地资料)。共16次提问,会话链连续;另有一条被源页面隐去的插件输出,不能声称恢复其内容。
数学基础使用矩阵乘法、指数与对数求导、多元链式法则、概率链式法则、期望与有限二阶矩下的方差性质。本文展开与问题直接有关的依据,不从实数构造或测度论重建这些基础。
- R1 Vaswani等,Attention Is All You Need:缩放点积、多头、原始编码器—解码器与FFN结构。
- R2 Bengio等,A Neural Probabilistic Language Model:概率语言模型与分布式表示背景。
- R3 Ba等,Layer Normalization:归一化定义。
- R4 Su等,RoFormer: Enhanced Transformer with Rotary Position Embedding:旋转位置编码。
- R5 Devlin等,BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding:双向编码器与不同训练目标。
- R6 Press与Wolf,Using the Output Embedding to Improve Language Models:输入输出共享参数。
正文与公式可单文件离线阅读,以上网络来源和本地资料链接只是补充。阅读索引见全部笔记;历史版本入口也在那里保留。