
切换深浅主题
第 12 章:输入、内部和输出层怎样一起训练
现在回到你最后的问题:“输出层也得有一个训练过程吗,还是和输入层一起?”下面保留原回答的联合训练说明,并把输入、输出共享参数的含义说清。
嵌入表在原问答记作W_E,在补充查表式中记作E;二者是同一个角色。词表大小统一记N,以免与Value矩阵V重名。
12.1 整个模型实际上是一个联合训练的系统
还是用:
患者服用华法林后出现____
正确答案是「黑便」。
模型不会先把输入层训练好,再把 Transformer 训练好,最后单独训练输出层。
在通常的预训练中,它们作为一个整体进行端到端训练(End-to-End Training)。
12.2 从数学上看,所有参数都属于同一个优化问题
我们将模型所有参数写成:
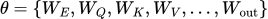
那么:

训练目标是找到使损失尽可能小的参数:
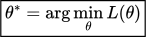
反向传播时,分别得到:
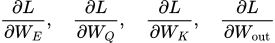
随后更新这些参数。
例如,使用最简单的梯度下降:
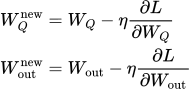
所有参数都根据同一次前向传播产生的损失接受训练信号。
这里的argmin是在写训练希望实现的优化目标,不保证实际算法一定达到全局最小值,甚至不预先保证该最小值在所用参数空间取得。实际训练是在给定资源和算法下尝试降低平均损失。
12.3 但输出层和输入层还有一种非常巧妙的关系
你可能会觉得:
输入层需要把 Token 变成向量:
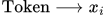
输出层则要把向量变回 Token 的概率分布:
这两个过程在用途上一个读入Token、一个给Token打分,但不是互为逆函数。
因此,许多语言模型采用一种叫做 Weight Tying(权重共享) 的设计。
假设词表大小为  ,模型隐藏维度为
 。
输入 Embedding 矩阵:

输出层可以使用:
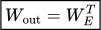
也就是说,输出层和输入 Embedding 层直接共享同一组参数。
这样做既能减少模型参数量,也能让输入和输出的 Token 表示使用同一个权重矩阵。
不过需要注意:不是所有 Transformer 语言模型都采用权重共享,有些模型会分别训练这两个矩阵。
12.4 为什么联合训练特别重要?
假设模型对「黑便」的预测概率只有 0.3。
出现这个问题,可能有许多原因:
- 输入层没有形成足够有用的 Token 表示。
- Q、K 的匹配没有很好地整合相关上下文。
- V 没有提供足够有用的信息。
- 后续 Transformer 层没有形成合适的隐藏表示。
- 输出层没有将隐藏表示正确映射到「黑便」的分数。
我们事先并不知道问题主要出现在哪一层。
联合训练的优势,就是不需要人为确定应该修改哪一层。
反向传播根据损失对各参数的梯度,自动计算不同参数的局部调整方向。
当然,这不意味着每次更新都一定能提高所有样本的预测准确率。优化器是在大量训练数据上不断尝试降低总体损失。
所以最准确的理解是:
一次前向传播得到多个位置的预测,同一个汇总损失提供训练信号;反向传播计算输入层、Transformer各层和输出层的梯度,再由优化器更新。它们通常共同学习。
这也解释了为什么单独讨论  的语义比较困难:一个参数是否有用,要看它与整个网络中其他参数组合起来,最终能否改善预测结果。
12.5 输入查表与输入层梯度,也用式子接起来
下面的查表公式只是把“按编号取一行”写清楚。 里冒号表示该行的全部列;one-hot行向量
 只在编号
 处为1,其他项为0,所以
 会选出E的那一行。
Tokenizer 把文本变成离散编号。假设“患者”编号为 17,“服用”编号为 92,这两个数之差 75 不表示语义距离。编号用于索引,不直接拿来做语言意义上的加减。
输入嵌入矩阵定义为:

第  行是词表中第 个 Token 的可训练向量。第
 个位置先查表得到行向量:
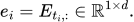
若用 one-hot 行向量  表示编号,则
 。查表和这个乘法数学上等价;实现无需真的构造巨大 one-hot。
若 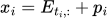 ,则:
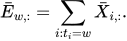
可训练的位置向量同样收到对应梯度;固定位置编码不更新。若  ,还需加来自输出路径的
 。训练更新可以同时影响“输入如何表示”和“输出如何打分”,无需分开进行两个训练过程。
12.6 预测函数、损失函数和优化目标的区别
对第i个位置,若加上输出偏置b:
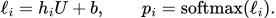
下标i表示这是第i位置作出的下一Token预测。 是一整组概率,不是单个数;要问“黑便”的概率,需要取这一组中属于“黑便”的那一项。
有时会写:
这里t1到t5是已有五块前文,竖线读作“在这些前文已知的条件下”。θ代表模型当前全部参数;把它写在p的下标,是提醒你换一套参数,预测概率也可能改变。整个式子表示一个数:这套模型给“黑便”分了多少概率。
公式并没有额外执行一步操作,只是把前面讲过的整个预测过程压缩记下来。
对可微标量损失  ,把所有参数展开成向量。由一阶展开:
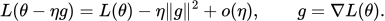
若  ,充分小的正
 使损失下降。有限步长不自动满足条件;批次损失下降也不保证所有样本或测试集表现改善。
反向传播是多元链式法则在计算图上的高效应用,求的是当前参数处的局部导数。梯度下降是更新规则;Adam 类方法再使用梯度的历史统计量调整更新。本文数值例子只用最简单的梯度下降。
12.7 这和反向传播有什么关系?
现在逻辑才真正完整。
因为损失函数可以写成:
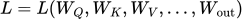
所以我们才能对这些矩阵求偏导。
例如:

它的意思是:
如果稍微改变 中的某个元素,最终预测「黑便」的损失会如何变化?
虽然 并不直接产生最终概率,但它会影响:
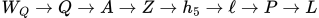
因此可以通过链式法则,一直把梯度传递回 。
这就是反向传播。
而且,输出层的  也需要训练,并不是一开始就知道「哪个隐藏向量应该对应黑便」。
12.8 现在我们可以把整个训练写成一个优化问题
最终,模型希望找到一组参数:
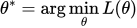
这里把 Transformer 和输出层的所有可训练参数统称为  。
更完整地说,是希望在大量训练样本上,使平均的下一个 Token 预测损失尽可能小。
所以三个概念需要明确区分:
| 概念 | 数学对象 | 作用 |
|---|---|---|
| Transformer |  | 将输入转化为上下文相关的隐藏表示 |
| 预测函数 | 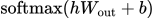 | 计算下一个 Token 的概率 |
| 损失函数 |  | 衡量预测结果与正确答案的差异 |
这里最重要的理解是:Transformer 并不是直接输出文字,而是先计算一个高维向量,再通过同样需要训练的输出矩阵,把它映射到词表上的概率分布。