
切换深浅主题
第 11 章:损失、导数与反向传播,沿原问答逐步推导
这一章保留原对话中从负对数、单参数导数、一次具体更新,再到矩阵和链式法则的整段展开。它本来就是帮助理解训练的关键内容,不再压缩成“用梯度下降”一句话。
11.1 为什么损失函数是 -ln p?
假设模型预测下一 Token 的概率分布为:
| 候选 Token | 预测概率 |
|---|---|
| 呼吸困难 | 0.45 |
| 黑便 | 0.30 |
| 呕血 | 0.15 |
| 其他 | 0.10 |
这里「黑便」是正确答案。
我们希望用一个数字衡量模型的预测有多差。
最直观的要求是:
- 如果正确答案的概率是 100%,损失应该是 0。
- 如果正确答案的概率很小,损失应该较大。
- 如果正确答案的概率接近 0,损失应该非常大。
函数:

恰好符合这些要求。
例如:
正确答案的概率  | 损失  |
|---|---|
| 0.01 | 4.605 |
| 0.10 | 2.303 |
| 0.30 | 1.204 |
| 0.50 | 0.693 |
| 0.90 | 0.105 |
| 1.00 | 0 |
所以刚才模型的损失是:
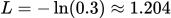
但这个 1.204 并不会直接告诉模型「应该增加  中哪个元素」。
它只是告诉模型:按照当前参数,这一次预测产生了多大的损失。
为什么特别选择对数?其中一个重要原因是概率模型的最大似然原理。假设多个训练目标的条件概率相乘,取负对数就能把乘积转换为求和:
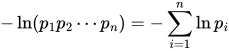
这样便于把多个 Token 的预测误差汇总为训练目标。
11.2 模型怎么知道修改参数的方向?
现在涉及你学过的导数。
先不要考虑复杂的矩阵 。
假设模型只有一个可调整的参数  ,而损失是它的函数:

我们想找到让  尽可能小的 。
你知道函数在某一点的导数:

反映函数在该点附近的变化率。
如果:

说明在当前位置附近,增加 会使损失增加,所以我们应该减小 。
反之,如果:

说明增加 会使损失减小,所以我们应该增加 。
因此可以统一写成:
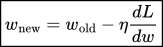
其中  称为学习率(Learning Rate),控制每次调整的幅度。
这就是梯度下降(Gradient Descent)最基本的原理。
11.3 我们实际计算一次参数更新
为了看清楚导数的作用,假设现在模型只需要在两个选项中预测:
- 正确答案:「黑便」
- 其他答案
我们用一个简单的函数表示模型给「黑便」的概率:

这里 是一个可训练的标量,代表正确答案相对其他答案的输出分数。它不是 ,只是为了展示训练机制而构造的简化模型。
损失函数变成:
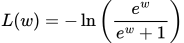
利用对数性质:
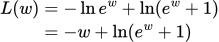
现在对 求导:
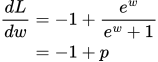
因此:
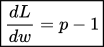
这是一个很漂亮的结果。
当正确答案的预测概率为 0.3 时:
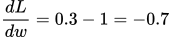
导数为负,说明增加 有助于减小损失。
假设学习率为:

那么梯度下降:
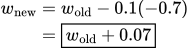
也就是说,模型根据导数,自动知道应该把这个参数增加 0.07。
最初  ,对应:
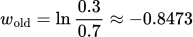
更新以后:
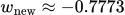
重新计算预测概率:
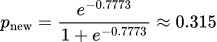
你可以看到:
模型并不需要有人告诉它「把参数增加 0.07」。只需要计算损失对参数的导数,就能自动找到局部降低损失的方向。
11.4 但 Transformer 的参数是矩阵,而不是一个数字
现在才回到真正的 Transformer。
我们有:

假设 是一个  的矩阵。
那么它包含:
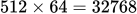
个元素。
我们把这些元素记为:
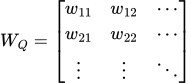
模型需要决定这 32768 个数字分别应该增加还是减少多少。
于是我们对每个元素都计算一个偏导数:

把所有偏导数组成一个与 同样大小的矩阵:
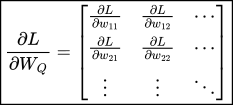
这就是梯度矩阵。
假设其中一小部分为:
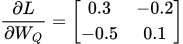
而学习率为  。
那么参数更新量是:
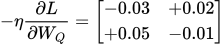
于是:
- 左上角参数减小 0.03。
- 右上角参数增加 0.02。
- 左下角参数增加 0.05。
- 右下角参数减小 0.01。
真实模型可以包含数十亿甚至更多参数,但基本原理仍然是这样。当然,实际训练中通常使用 AdamW 等优化器,而不仅是最简单的梯度下降。
11.5 最关键的问题:损失 L 怎么对 WQ 求导?
这是反向传播真正厉害的地方。
回顾我们学过的前向计算:

然后:
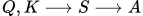
再与  运算:

经过其他 Transformer 模块,得到最终隐藏向量  ,然后通过输出层计算概率 ,最后得到损失 。
注意:这里从 到 ,并不是一个简单函数,而是许多函数的复合。
你学过复合函数求导法则:
如果:
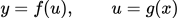
那么:
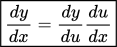
这就是链式法则(Chain Rule)。
对于神经网络,原理完全一样。
如果把中间运算简化成一条依赖链,那么:
逐步反向计算导数。
真实网络有分支、矩阵和残差连接,因此反向传播还需要汇总不同路径传回来的梯度,但基本数学原理仍然是多元函数的链式法则。
甚至我们可以对最初的:
直接写出矩阵形式的梯度:
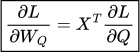
这里把来自下游所有路径的梯度都汇总到了  ,并把
 看成已知输入。
所以只要我们算出了损失相对于  的梯度,就可以进一步算出损失相对于 的梯度。
这就是反向传播不是在倒着重新猜参数,而是在沿计算图系统地应用链式法则。
最后把训练过程与推理过程对应起来
| 阶段 | 进行的计算 |
|---|---|
| 前向传播 | 用 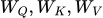 等参数处理输入,计算预测概率 |
| 损失计算 | 根据正确 Token,计算 |
| 反向传播 | 使用链式法则计算所有参数的梯度 |
| 参数更新 | 使用梯度和优化器调整参数 |
| 下一轮训练 | 使用更新后的参数重新预测 |
而你实际与 ChatGPT 对话的时候,通常只进行前向计算和 Token 生成,不执行这种针对本次对话的梯度更新。
最重要的结论是:
Transformer 的「学习」不是给某个词手动赋予意义,也不是直接修改注意力权重  。
它是通过计算最终预测误差对各个参数的偏导数,不断修改 等矩阵。随后这些矩阵在新的前向传播中产生新的 Q、K、V,进而改变注意力分配和最后的预测结果。
而这整个训练机制,从数学上讲,核心就是你已经接触过的多元函数求导、链式法则和梯度下降。
11.6 最后把训练过程与推理过程对应起来
| 阶段 | 进行的计算 |
|---|---|
| 前向传播 | 用 等参数处理输入,计算预测概率 |
| 损失计算 | 根据正确 Token,计算 |
| 反向传播 | 使用链式法则计算所有参数的梯度 |
| 参数更新 | 使用梯度和优化器调整参数 |
| 下一轮训练 | 使用更新后的参数重新预测 |
而你实际与 ChatGPT 对话的时候,通常只进行前向计算和 Token 生成,不执行这种针对本次对话的梯度更新。
最重要的结论是:
Transformer 的「学习」不是给某个词手动赋予意义,也不是直接修改注意力权重 。
它是通过计算最终预测误差对各个参数的偏导数,不断修改 等矩阵。随后这些矩阵在新的前向传播中产生新的 Q、K、V,进而改变注意力分配和最后的预测结果。
而这整个训练机制,从数学上讲,核心就是你已经接触过的多元函数求导、链式法则和梯度下降。
11.7 为什么选负对数:把原来的依据补成公式链
下面把目标概率、交叉熵与整段训练目标连成完整公式。目标分布 就是:真实Token那一项为1,其余候选为0;这叫one-hot。
 表示候选w上的这个数。
若目标编号是 y,用 one-hot 目标分布  ,交叉熵为:
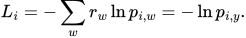
正确目标概率提高,损失严格下降。但仅凭“概率低时罚得多”并不能唯一确定对数形式。
更系统的依据是条件最大似然。对一段已知文本,条件概率链式分解给出:
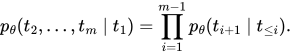
这来自概率链式法则,不要求 Token 独立。最大化这个乘积等价于最小化其负对数,即各位置负对数之和。多个训练样本则按给定训练采样与目标求和或平均。[来源 R2 提供神经概率语言模型背景]
定义有效目标集合  ,平均损失写为:
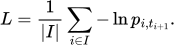
padding 与不计分位置应排除。某些对话微调仅在助手回答位置计损失;这是损失掩码,作用不同于因果注意力掩码。后者控制信息流,前者控制哪些位置计入目标。