
切换深浅主题
第 1 章:先弄清输入、预测、训练和输出
你原来的追问里,有两句应该先放到最前面:“我们输入的是一句话吧?”“这一步到底是在训练还是在输出?”
先明确这两件事,后面看到Q、K、V时,才知道它们处在整个流程的哪里。这里先看全貌,不要求现在理解注意力内部公式。
1.1 先固定同一个例子
我们沿用原问答中的句子:
患者服用华法林后出现黑便。
本文主要用同一套教学分词:

 表示第i个位置的Token;下标是位置,不是向量坐标。真实Tokenizer不一定这样切,这里只为清楚地对应每个位置。
如果输入到“出现”为止,要预测的是“黑便”这个候选;如果输入已经包含“黑便。”,那么要预测的就是句号之后的内容。不要把“读取已经给出的黑便”和“在它还没给出时预测黑便”当成同一件事。
1.2 一句话如何成为整个输入矩阵
首先,每个Token有一个编号,编号用来查嵌入表,取出一行数值向量。例如“患者”的向量可以写成  ,“出现”的向量写成
 。
输入前五个Token时,模型接收的是:
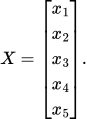
本文统一把 视为行向量;每行有d个数,X就是5行d列。这叫
 ,只表示这张实数表的行列数。
模型处理的是整个X。 解释时只盯着某一行,是为了看清这个位置怎样计算,不是说模型只收到一个孤立词语。位置的信息也要进入计算,第7章说明具体做法。
1.3 这一步究竟属于训练,还是使用模型
训练和生成都会先根据输入算一次预测,这一段叫前向传播。
训练时,数据里已经有完整句子。模型根据到“出现”为止的前文,算“黑便”等候选的概率,再拿真实目标“黑便”评分。评分结果用来计算各参数怎样调整,最后执行更新。
生成时,后续还没提供。模型同样先计算概率,再选一个Token追加到前文,接着计算下一项。通常不会因为这次生成而改变参数。
所以我们之后看到的注意力运算,不是“只在训练时算”或“只在输出时算”,而是两者共用的前向计算。完整同句示例在第10章;这里先不引入内部字母。
1.4 把训练与推理放在一起对照
| 做的事情 | 训练 | 生成 |
|---|---|---|
| 把整段前文变成向量 | 要做 | 要做 |
| 用注意力与后续网络计算预测 | 要做 | 要做 |
| 已知数据给出的真实下一Token | 是 | 未提供后续目标 |
| 按真实目标计算损失、梯度 | 要做 | 普通生成通常不做 |
| 更新可训练参数 | 要做 | 普通生成通常不做 |
| 把选出的Token接回去继续生成 | 标准训练使用真实前文 | 要做 |
“输出”还可能指模块输出的一串数,而不是最终文字。后面会分别叫它们中间向量、预测概率和生成文字。
1.5 先只记住这一条流程
共同的前向计算是:
输入文字 → Token向量 → 多层Transformer → 隐藏表示 → 输出打分 → 下一Token概率。
训练再接“读取真实目标 → 算损失 → 求梯度 → 更新参数”;生成再接“选一个Token → 放回前文 → 继续预测”。
后面说“输出”,可能指某个模块输出的向量,也可能指最终生成的文字。本文会区分:z是注意力的中间结果,h是整个网络处理后的表示,候选概率和文字还在它们之后。