
切换深浅主题
第 8 章:已知私钥怎样随机分解模数
8.1 私钥给了我们哪一条额外信息
沿用 ,其中
 为不同奇质数。原对话的私钥关系给出
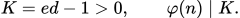
对于任意与 互质的
 ,欧拉定理保证
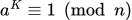 。我们知道
 ,所以能计算
 ;这一步并不要求知道。证明中使用解释算法,算法本身不能预先使用它们。
把中的全部因子2提出,写成 ,其中
 为奇数。由于
 是偶数,这里
 。接着构造连续平方序列

第 项同余于
 ,因此终点
 。我们不是盲目平方;终点已由指数条件保证,现在要研究第一次到1之前的一项。
8.2 为什么“平方为1”能产生因子
若某个 满足
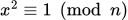 ,则
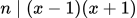 。模
 看,是质数,所以必须整除
 或
 ,即
 或
 。模
 同理。
因此的两个CRT坐标只能是下面四种组合:
| 模 | 模 | 合并后的意义 |
|---|---|---|
 | | 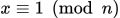 |
 | | 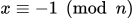 |
| | 两边符号不同 |
| | 两边符号不同 |
CRT保证每种组合对应一个根。因为都为奇数,模各个质数的1与不同,所以这四个根也互不相同。
最后两种称为1的非平凡平方根。若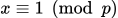 、
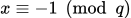 ,那么
 ,但
 ;否则会同时整除与,进而整除它们的差2,与为奇质数矛盾。因此

符号相反时两个因子互换。最大公约数提取因子,是因为两个质因子分别落在和中,不是仅凭“平方为1”就能分解。若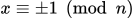 ,得到的只是1或整个,没有拆出因子。
8.3 第一次到1之前的一项为什么值得检查
假设 ,并设
 是序列第一次出现的1,那么
 。它的前一项
 满足
 ,但
 ,因为这是第一次到1。
所以前一项只剩两种可能:它等于,算法这次失败;或者它是非平凡平方根,可以提取因子。初始就为1时也失败,因为没有前一项可检查。
一个简短核对是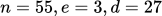 ,从而
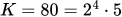 。取
 ,初始项
 ,随后平方得到
 、1。前一项34不是1或54,所以得到
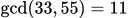 。它只是一般算法的一次实例;成功条件来自上一节的四种符号组合。
8.4 完整算法与失败分支
算法可以写成下面的顺序。所有余数均取 至
 的代表,输入满足上面的指数条件。
- 从
 均匀选取,计算
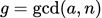 。若
 ,因
 ,
 已是一个真因子,输出
 。
- 若
 ,计算
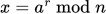 。若
 ,本次失败,重新独立选取底数。
- 最多进行
 轮:令
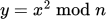 。若
 ,令
 继续;若
 且
 ,本次失败;若且
 ,输出
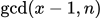 及另一个因子。
最后一个分支里的也不可能是1:初始为1的情况已排除,后续一出现1就终止。因此它确实是非平凡平方根。合法输入下一定能在轮内到达1,因为 。输出因子可以用乘法检查。
8.5 为什么还需要证明概率
我们已经证明:若遇到非平凡平方根,算法会成功;也说明它可能失败。尚未证明的是,随机选择底数会多频繁地产生有用的根。
不能仅凭“四个平方根有两个有用”就断言成功率为一半。连续平方产生四个根的概率未必相同。需要从随机底数出发,分析算法实际到达哪一个根。接下来的三章完成这一步。