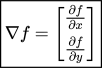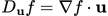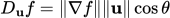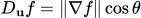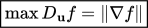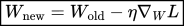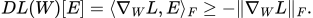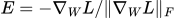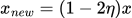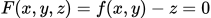Skip to content

第 3 章:梯度为何是最速方向,以及它位于哪个空间 ​

返回目录

对,梯度向量(Gradient Vector)指向函数值增长最快的方向,而梯度的模长表示该方向上的最大变化率。

不过需要区分两个概念:

  • 梯度的方向:函数值上升最快的方向。
  • 梯度的模长:沿该方向移动单位距离时,函数值的最大瞬时变化率。

假设有一个二元函数:

z=f(x,y)

它的梯度为:

\boxed{\nabla f=
\begin{bmatrix}
\frac{\partial f}{\partial x}\\
\frac{\partial f}{\partial y}
\end{bmatrix}}

梯度位于输入变量构成的空间中,指向函数值增长最快的方向,并与等高线正交(梯度非零时)。

为什么梯度是变化率最大的方向? ​

考虑沿单位方向向量 \mathbf u 移动,函数的方向导数为:

D_{\mathbf u}f=\nabla f\cdot\mathbf u

根据向量点积:

D_{\mathbf u}f
=
\|\nabla f\|\|\mathbf u\|\cos\theta

因为 \|\mathbf u\|=1,所以:

D_{\mathbf u}f=\|\nabla f\|\cos\theta

当 \theta=0 时,变化率最大:

\boxed{\max D_{\mathbf u}f=\|\nabla f\|}

也就是沿梯度方向移动。

联系 Transformer 的梯度下降 ​

Transformer 训练的目标是减小损失函数 L,而不是增大它。

因此,更新参数时沿着负梯度方向:

\boxed{W_{\mathrm{new}}=W_{\mathrm{old}}-\eta\nabla_W L}

这里虽然 \nabla_W L 是矩阵,但我们可以把矩阵中的所有参数展开成一个高维向量。

例如,一个 3\times2 的权重矩阵实际上对应 6 个独立参数,因此损失函数可以理解为定义在六维参数空间上的函数:
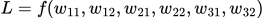
L=f(w_{11},w_{12},w_{21},w_{22},w_{31},w_{32})

梯度矩阵本质上就是这个六维梯度向量的另一种排列方式。

所以,梯度下降可以理解成:在模型参数构成的高维空间中,每一步都沿着损失函数局部下降最快的方向调整参数。

需要注意,这里的方向是在参数空间中,而不是三维曲面上的切线方向;它是损失函数在参数空间中的最陡上升方向。

图 1 · 梯度在输入平面内,与等高线正交p圆:f(x,y) = x² + y² 的等高线橙色:∇f(p) = (2,1)绿色:负梯度方向比较单位方向的一阶变化率。有限步长还要考虑高阶变化。
点 p=(1,1/2)。径向梯度与圆的切线垂直;箭头表示输入空间方向,不是三维曲面的法向量。

补充:梯度为零时,以及有限步长的限制 ​

方向导数公式要求 f 在该点可微。若 \nabla f(p)=0,所有单位方向的一阶方向导数都是零,此时不存在由非零梯度指定的唯一最陡方向。

对矩阵变量,在 \|E\|_F=1 的约束下同样有

DL(W)[E]=\langle\nabla_WL,E\rangle_F
\geq-\|\nabla_WL\|_F.

非零梯度时,取 E=-\nabla_WL/\|\nabla_WL\|_F 达到最小值。这里“最快”依赖所选的欧氏/Frobenius 度量;若换度量,最陡方向的表示也可能变化。

若梯度非零,可微性给出
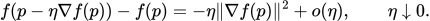
f(p-\eta\nabla f(p))-f(p)
=-\eta\|\nabla f(p)\|^2+o(\eta),\qquad\eta\downarrow0.

所以足够小的正步长会下降;任意步长则没有保证。对 f(x)=x^2,更新为 x_{new}=(1-2\eta)x,对非零 x 仅当 0<\eta<1 时一步严格下降。把局部最速方向直接解释成“大步也最优”,会遗漏高阶变化。

对图形 z=f(x,y),\nabla f 是输入平面中的二维向量。曲面写成隐式方程 F(x,y,z)=f(x,y)-z=0 时,其法向量为 (f_x,f_y,-1),与二维梯度不是同一个对象。

保留每一次追问,认真走完每一步证明。