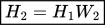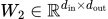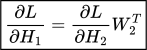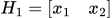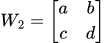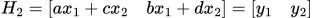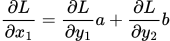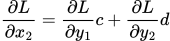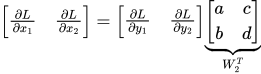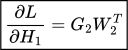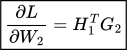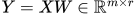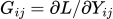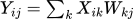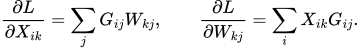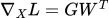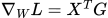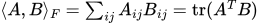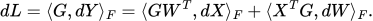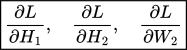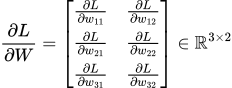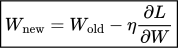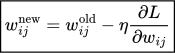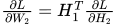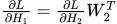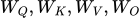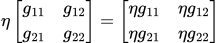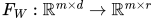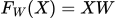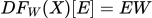Skip to content

第 2 章:标量对矩阵的梯度、链式法则与参数更新 ​

返回目录

你之前问过 Transformer 反向传播时,梯度为什么也是一个矩阵,以及为什么计算时需要转置。我们沿用之前的 H_1,W_2,H_2,L 来回顾。
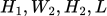
一、梯度矩阵是什么? ​

假设 Transformer 中有一个线性变换:

\boxed{H_2=H_1W_2}

其中:

H_1\in\mathbb R^{n\times d_{\mathrm{in}}}
W_2\in\mathbb R^{d_{\mathrm{in}}\times d_{\mathrm{out}}}
H_2\in\mathbb R^{n\times d_{\mathrm{out}}}

最终通过后续计算得到一个标量损失:

L\in\mathbb R

我们想知道:如果 H_2 的每一个元素发生微小变化,损失 L 会变化多少?

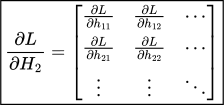
于是分别求偏导,并将结果按照 H_2 的形状排列:

\boxed{
\frac{\partial L}{\partial H_2}
=
\begin{bmatrix}
\frac{\partial L}{\partial h_{11}}&
\frac{\partial L}{\partial h_{12}}&
\cdots\\
\frac{\partial L}{\partial h_{21}}&
\frac{\partial L}{\partial h_{22}}&
\cdots\\
\vdots&\vdots&\ddots
\end{bmatrix}
}

这个就是梯度矩阵(gradient matrix)。

需要注意,它不是矩阵求导后凭空出现的新概念,而是将每个元素的偏导数重新排列成矩阵。

二、梯度如何向前一层传递? ​

我们已经知道:

H_2=H_1W_2

同时已经计算出:

G_2=\frac{\partial L}{\partial H_2}

现在想求:

G_1=\frac{\partial L}{\partial H_1}

依据链式法则,最终有:

\boxed{
\frac{\partial L}{\partial H_1}
=
\frac{\partial L}{\partial H_2}W_2^T
}

为什么会出现转置?

考虑一个最简单的例子。

H_1=\begin{bmatrix}x_1&x_2\end{bmatrix}
W_2=
\begin{bmatrix}
a&b\\
c&d
\end{bmatrix}

因此:

H_2=
\begin{bmatrix}
ax_1+cx_2&bx_1+dx_2
\end{bmatrix}
=
\begin{bmatrix}y_1&y_2\end{bmatrix}

根据链式法则:

\frac{\partial L}{\partial x_1}
=
\frac{\partial L}{\partial y_1}a+
\frac{\partial L}{\partial y_2}b
\frac{\partial L}{\partial x_2}
=
\frac{\partial L}{\partial y_1}c+
\frac{\partial L}{\partial y_2}d

写成矩阵:

\begin{bmatrix}
\frac{\partial L}{\partial x_1}&
\frac{\partial L}{\partial x_2}
\end{bmatrix}
=
\begin{bmatrix}
\frac{\partial L}{\partial y_1}&
\frac{\partial L}{\partial y_2}
\end{bmatrix}
\underbrace{
\begin{bmatrix}
a&c\\
b&d
\end{bmatrix}
}_{W_2^T}

所以,转置并不是单纯为了让矩阵维度匹配,而是链式法则展开后自然得到的结果。

三、反向传播的三个重要梯度公式 ​

对于线性层:

H_2=H_1W_2

令:

G_2=\frac{\partial L}{\partial H_2}

那么:

  1. 对输入 H_1 求梯度:将梯度传回前一层
\boxed{\frac{\partial L}{\partial H_1}=G_2W_2^T}
  1. 对权重 W_2 求梯度:用于更新模型参数
\boxed{\frac{\partial L}{\partial W_2}=H_1^TG_2}
  1. 对输出 H_2 求梯度:从后续计算传来的梯度
\boxed{G_2=\frac{\partial L}{\partial H_2}}

注意,求偏导时其他变量仍然保持当前数值不变。比如求 \partial L/\partial H_1 时,W_2 视为常量;但 W_2 本身也是需要训练的参数,所以我们还会单独计算 \partial L/\partial W_2。

四、如何理解整个反向传播? ​

对 Transformer 来说,整个模型虽然包含 Q、K、V、Attention、MLP 等复杂模块,但反向传播的基本原理都是这个链式法则。

还有一个很容易混淆的概念:

  • 梯度矩阵(Gradient matrix):标量 L 对矩阵各元素求偏导,结果通常与原矩阵同形状。
  • 雅可比矩阵(Jacobian matrix):向量对向量求导,表示每个输出元素对每个输入元素的影响。

我们上面实际上是利用雅可比矩阵描述的关系,通过链式法则计算梯度,只不过矩阵运算让我们不必显式构造巨大的雅可比矩阵。

你之前最容易混淆的地方,其实就是三个不同的问题:对输入求导、对权重求导、对输出求导。 只要始终明确正在求谁的梯度,转置应该放在哪一边就容易理解了。

补充:权重梯度逐元素推导 ​

记 X\in\mathbb R^{m\times d}、W\in\mathbb R^{d\times r}、Y=XW\in\mathbb R^{m\times r},并令 G_{ij}=\partial L/\partial Y_{ij}。由 Y_{ij}=\sum_kX_{ik}W_{kj},有

\frac{\partial L}{\partial X_{ik}}=\sum_jG_{ij}W_{kj},\qquad
\frac{\partial L}{\partial W_{kj}}=\sum_iX_{ik}G_{ij}.

因此 \nabla_XL=GW^T、\nabla_WL=X^TG。维度检查只能排错,不能替代这段链式法则证明。如果另有通往 L 的依赖路径,还要累加各路径贡献。

用 Frobenius 内积 \langle A,B\rangle_F=\sum_{ij}A_{ij}B_{ij}=\operatorname{tr}(A^TB),同一关系也可写成

dL=\langle G,dY\rangle_F
=\langle GW^T,dX\rangle_F+\langle X^TG,dW\rangle_F.

这个等式解释了梯度为何按照与原变量相同的形状表示:它是微分这个线性泛函在 Frobenius 内积下的代表。

对,完全正确。我们之前讨论的反向传播梯度,都是标量对矩阵求梯度,而不是矩阵对矩阵求导。

关键在于:损失函数 L 最终是一个标量。

例如:

H_2=H_1W_2

虽然 H_1,H_2,W_2 都是矩阵,但最终的损失是:

L\in\mathbb R

因此,我们计算的是:

\boxed{
\frac{\partial L}{\partial H_1},\quad
\frac{\partial L}{\partial H_2},\quad
\frac{\partial L}{\partial W_2}
}

它们都是标量对矩阵的梯度。

那么矩阵对矩阵求导是什么? ​

例如:

Y=XW

如果直接计算:

\frac{\partial Y}{\partial X}

由于 Y 和 X 都是矩阵,严格来说,我们需要描述 Y 中每个元素对 X 中每个元素的偏导数。

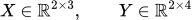
假设:

X\in\mathbb R^{2\times3},\qquad
Y\in\mathbb R^{2\times4}

那么 Y 有 8 个元素,X 有 6 个元素。

因此,如果把两个矩阵分别展平成向量,它们之间的雅可比矩阵就是:
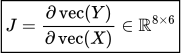
\boxed{
J=\frac{\partial\operatorname{vec}(Y)}
{\partial\operatorname{vec}(X)}
\in\mathbb R^{8\times6}
}

也可以不展平,使用四阶张量表示。

为什么 Transformer 不需要显式计算这种巨大的雅可比矩阵? ​

因为反向传播使用的是向量-雅可比积(Vector–Jacobian Product, VJP)。

例如:

H_2=H_1W_2

虽然中间存在 H_2 对 H_1 的雅可比矩阵,但是我们真正需要的是:

\boxed{
\frac{\partial L}{\partial H_1}
=
\frac{\partial L}{\partial H_2}W_2^T
}

这相当于将损失梯度与局部雅可比矩阵相乘,而不需要显式构建它。

所以你可以这样记忆:

  • 前向传播:矩阵经过矩阵运算,得到新的矩阵。
  • 反向传播:从标量损失 L 出发,逐层计算 L 对各个矩阵的梯度。
  • 数学原理:矩阵之间的雅可比关系 + 链式法则。
  • 计算实现:通常只计算向量-雅可比积,避免构造完整的雅可比矩阵。

这也是为什么深度学习中的自动微分能够高效地处理包含海量参数的神经网络。

对,这正是梯度下降(Gradient Descent)的核心要求:我们需要计算出一个与权重矩阵 W 形状完全相同的梯度矩阵,才能逐元素更新参数。

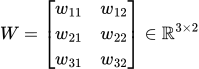
假设权重矩阵是:

W=
\begin{bmatrix}
w_{11}&w_{12}\\
w_{21}&w_{22}\\
w_{31}&w_{32}
\end{bmatrix}
\in\mathbb R^{3\times2}

损失函数 L 是一个标量,对 W 求梯度:

\frac{\partial L}{\partial W}
=
\begin{bmatrix}
\frac{\partial L}{\partial w_{11}}&
\frac{\partial L}{\partial w_{12}}\\
\frac{\partial L}{\partial w_{21}}&
\frac{\partial L}{\partial w_{22}}\\
\frac{\partial L}{\partial w_{31}}&
\frac{\partial L}{\partial w_{32}}
\end{bmatrix}
\in\mathbb R^{3\times2}

然后梯度下降的更新公式就是:

\boxed{W_{\mathrm{new}}=W_{\mathrm{old}}-\eta\frac{\partial L}{\partial W}}

其中 \eta 是学习率(learning rate)。

展开到每一个参数:

\boxed{
w_{ij}^{\mathrm{new}}
=
w_{ij}^{\mathrm{old}}
-\eta\frac{\partial L}{\partial w_{ij}}
}

也就是说,每个权重都有一个对应的偏导数,告诉我们应该朝哪个方向调整这个权重,才能在局部近似下使损失减小。

再联系之前的线性层:

H_2=H_1W_2

反向传播会同时计算两种梯度:

梯度作用
\frac{\partial L}{\partial W_2}=H_1^T\frac{\partial L}{\partial H_2}更新权重矩阵 W_2
\frac{\partial L}{\partial H_1}=\frac{\partial L}{\partial H_2}W_2^T将梯度传递给前一层

这里有一个重要区别:

对 W_2 求梯度,是为了更新这一层的参数;对 H_1 求梯度,是为了继续反向传播。

所以,虽然反向传播会计算很多梯度矩阵,但真正用于梯度下降更新的,是损失函数对各个可训练参数矩阵的梯度。

你现在其实已经把 Transformer 训练过程的关键逻辑串起来了:

\boxed{
\text{前向计算 }L
\longrightarrow
\text{反向计算 }\nabla_W L
\longrightarrow
\text{更新 }W
}

Transformer 中的 W_Q,W_K,W_V,W_O 以及 MLP 层的权重矩阵,都是按照这个基本原理学习的。

对,\eta(希腊字母 eta)就是学习率(Learning Rate),在标准梯度下降中是一个标量(scalar)。

梯度下降公式:
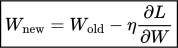
\boxed{W_{\text{new}}=W_{\text{old}}-\eta\frac{\partial L}{\partial W}}

其中:

  • W:权重矩阵,例如 3\times 2。
  • \frac{\partial L}{\partial W}:梯度矩阵,同样是 3\times 2。
  • \eta:学习率,是一个标量,例如 0.001。

因此,\eta 会乘以梯度矩阵中的每一个元素:

\eta
\begin{bmatrix}
g_{11}&g_{12}\\
g_{21}&g_{22}
\end{bmatrix}
=
\begin{bmatrix}
\eta g_{11}&\eta g_{12}\\
\eta g_{21}&\eta g_{22}
\end{bmatrix}

补充:矩阵到矩阵的导数没有消失 ​

对映射 F_W:\mathbb R^{m\times d}\to\mathbb R^{m\times r}、F_W(X)=XW,导数是线性映射 DF_W(X)[E]=EW。按列展平后,Jacobian 的形状为 mr\times md,并可写为 W^T\otimes I_m。本版不需要计算 Kronecker 积;只需要分清它与同形梯度是不同对象。

“前向矩阵对矩阵、最终标量损失对参数求梯度”可以同时成立。采用列梯度约定,反传写成 J^Tg;采用行协向量约定,写成 g^TJ,这就是通常所说的 VJP。名称里的行列约定不应改变实际链式法则。

现代自适应优化器可保留标量基础学习率,同时逐参数缩放更新;这不改变本章对标准梯度下降的定义。

保留每一次追问,认真走完每一步证明。